APIPark vs wav2vec 2.0
Al comparar APIPark vs wav2vec 2.0, ¿cuál herramienta AI Large Language Model (LLM) brilla con más intensidad? Examinamos precios, alternativas, votos positivos, características, opiniones, y más.
Entre APIPark y wav2vec 2.0, ¿cuál es superior?
Cuando ponemos APIPark y wav2vec 2.0 uno al lado del otro, ambas siendo herramientas impulsadas por inteligencia artificial en la categoría de large language model (llm), Ambas herramientas han recibido la misma cantidad de votos positivos de usuarios de aitools.fyi. ¡Cada voto cuenta! Emite el tuyo y contribuye a la decisión del ganador.
¿Crees que nos equivocamos? ¡Emite tu voto y muéstranos quién manda!
APIPark

¿Qué es APIPark?
APIPark es una puerta de enlace LLM de código abierto y un portal para desarrolladores de API para empresas que necesitan un lugar único para llamar, gobernar y facturar modelos de IA y APIs internas. Dirige el tráfico a más de 200 modelos de lenguaje grandes a través de un único endpoint compatible con OpenAI, para que los equipos dejen de conectar SDKs de proveedores separados por cada modelo que añaden.
Mientras que la mayoría de las puertas de enlace API solo reenvían solicitudes, APIPark también trata los modelos y APIs como activos comerciables. Agrupa autenticación unificada, flujos de aprobación, facturación por recarga, distribución multinivel e informes de ganancias para que los equipos de plataforma puedan vender capacidad excedente de modelos o empaquetar APIs de negocio sin construir una pila de mercado separada.
Los ingenieros de plataforma y equipos de IA lo usan para establecer cuotas por inquilino, límites de tasa y reglas de enmascaramiento antes de que el tráfico de producción llegue a los modelos ascendentes. Los gestores de API obtienen portales para publicar APIs, rastrear uso y aprobar solicitudes de acceso. La Edición Comunitaria cubre las funciones básicas de puerta de enlace y portal; la Edición Empresarial añade gobernanza avanzada, estadísticas en tiempo real y soporte premium.
wav2vec 2.0
¿Qué es wav2vec 2.0?
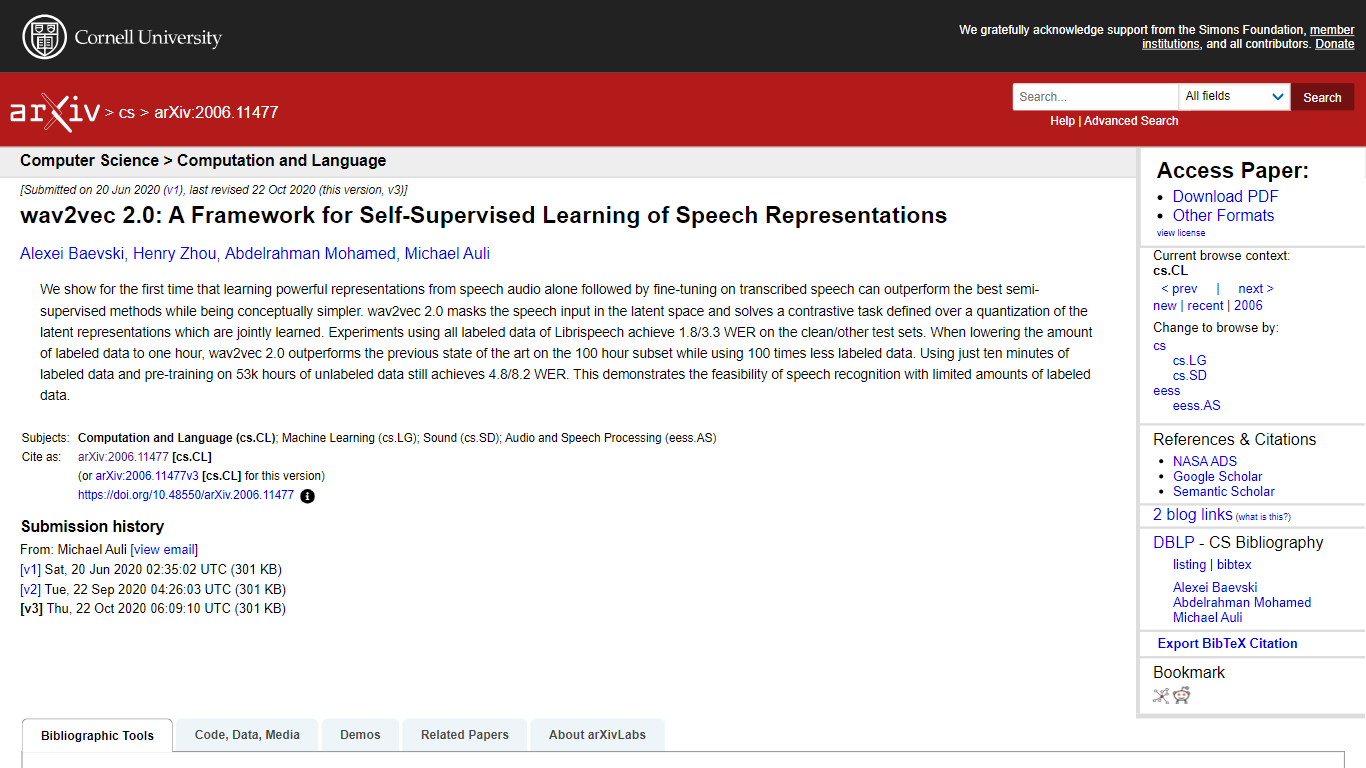
wav2vec 2.0 es un marco de aprendizaje auto-supervisado que aprende representaciones del habla directamente del audio en bruto. Enmascara porciones de la entrada de habla en un espacio latente y resuelve una tarea contrastiva sobre representaciones latentes cuantizadas, las cuales se aprenden conjuntamente con el modelo. Este enfoque permite que el modelo aproveche de manera efectiva grandes cantidades de datos de habla no etiquetados. Después de la pre-entrenamiento, wav2vec 2.0 puede ser ajustado finamente con pequeñas cantidades de datos de habla etiquetados para lograr un rendimiento de reconocimiento de voz de última generación. El modelo ha demostrado resultados sólidos incluso cuando se ajusta finamente con solo minutos de audio etiquetado, lo que lo hace altamente eficiente para escenarios de recursos limitados.
El marco simplifica el reconocimiento de voz eliminando la necesidad de pipelines complejos semi-supervisados, confiando en cambio en un único modelo de extremo a extremo. Logra tasas de error de palabra impresionantes en benchmarks estándar como Librispeech y TIMIT, superando métodos anteriores que requieren mucho más datos etiquetados. La cuantización de las representaciones latentes del habla permite que el modelo aprenda unidades discretas del habla, lo que mejora la robustez y la capacidad de generalización.
wav2vec 2.0 está dirigido a investigadores y desarrolladores que trabajan en reconocimiento de voz, especialmente aquellos interesados en aprovechar datos de audio no etiquetados para reducir los costos de anotación. Su capacidad para rendir bien con datos limitados etiquetados abre oportunidades para construir sistemas de voz en idiomas o dominios con recursos bajos. La arquitectura del modelo se basa en codificadores de características convolucionales y redes Transformer, lo que le permite capturar patrones de habla tanto locales como globales.
Técnicamente, wav2vec 2.0 combina aprendizaje contrastivo con una estrategia de enmascaramiento aplicada en el espacio latente, lo cual difiere de enfoques anteriores que enmascaran directamente el audio de entrada. Esta elección de diseño mejora la calidad de las representaciones aprendidas. El modelo se entrena en grandes conjuntos de datos no etiquetados, como 53,000 horas de habla, y se ajusta finamente en subconjuntos más pequeños etiquetados. Este proceso de entrenamiento en dos fases equilibra escalabilidad y precisión.
En resumen, wav2vec 2.0 representa un avance significativo en el aprendizaje de representaciones de habla auto-supervisado. Reduce la dependencia de datos etiquetados, simplifica las canalizaciones de entrenamiento y logra un rendimiento competitivo o superior en comparación con métodos completamente supervisados o semi-supervisados. La publicación del código y modelos preentrenados apoya la adopción y la investigación avanzada en tecnología del habla.
APIPark Votos positivos
wav2vec 2.0 Votos positivos
APIPark Características principales
Rutas 200+ LLMs a través de una sola firma de API compatible con OpenAI para que el código cliente existente no requiera reescrituras específicas del proveedor
Implementa la puerta de enlace y el portal de desarrolladores en aproximadamente 5 minutos con una sola instalación por línea de comandos
El equilibrio de carga distribuye las solicitudes entre las instancias de LLM para mantener la conmutación por error y el rendimiento predecibles bajo carga
La facturación API incorporada rastrea el consumo por usuario para que los equipos puedan medir y monetizar el acceso interno o de socios a la API
Cuotas detalladas limitan el gasto diario o mensual por cantidad, tokens o recuento de llamadas para bloquear el uso descontrolado del modelo
El motor de enmascaramiento de datos señala y enmascara campos sensibles en las cargas útiles de solicitud y respuesta para flujos de trabajo de cumplimiento
wav2vec 2.0 Características principales
El preentrenamiento auto-supervisado en audio sin procesar 🎧 permite aprender de datos de voz sin etiquetar
El enmascaramiento en el espacio latente 🎭 mejora la concentración del modelo en el contexto y la robustez
La tarea contrastiva sobre representaciones cuantificadas 🔄 ayuda a aprender unidades discretas de voz
El ajuste fino con datos etiquetados mínimos 📝 logra una alta precisión en el reconocimiento de voz
La arquitectura basada en Transformer 🔗 captura eficazmente dependencias de voz a largo plazo
APIPark Categoría
- Large Language Model (LLM)
wav2vec 2.0 Categoría
- Large Language Model (LLM)
APIPark Tipo de tarificación
- Freemium
wav2vec 2.0 Tipo de tarificación
- Freemium