Cognee vs wav2vec 2.0
En la confrontación entre Cognee vs wav2vec 2.0, ¿cuál herramienta AI Large Language Model (LLM) sale victoriosa? Evaluamos opiniones, precios, alternativas, características, votos positivos, y más.
Cuando ponemos a Cognee y wav2vec 2.0 cara a cara, ¿cuál emerge como el vencedor?
Echemos un vistazo más de cerca a Cognee y wav2vec 2.0, ambas son herramientas impulsadas por inteligencia artificial en la categoría de large language model (llm), y veamos qué las distingue. Ambas herramientas son igualmente favoritas, como lo indica el conteo idéntico de votos positivos. ¡Cada voto cuenta! Emite el tuyo y contribuye a la decisión del ganador.
¿No estás de acuerdo con el resultado? ¡Vota por tu herramienta favorita y ayúdala a ganar!
Cognee

¿Qué es Cognee?
Cognee convierte documentos, chats, tickets y datos de API en agentes de modelos de lenguaje con memoria gráfica que pueden recordar a lo largo de las sesiones. Construye grafos de entidades vinculadas a partir de ese contexto para que los agentes no tengan que empezar desde cero en cada ejecución. Puedes conectar Slack, GitHub o Linear para que los agentes de codificación y los bots de soporte compartan un cerebro empresarial consciente de los permisos.
El RAG simple devuelve fragmentos de texto similares. Cognee combina la búsqueda vectorial con grafos de conocimiento y ontologías auto-generadas, por lo que la recuperación extrae entidades conectadas y hechos citados en lugar de fragmentos aislados. El SDK se centra en cuatro verbos: recordar, recuperar, olvidar y mejorar, y la misma interfaz se ofrece a través de HTTP y MCP para Claude Code, Codex y OpenClaw.
Los equipos de plataforma lo usan para la memoria de agentes de codificación, pipelines GraphRAG, inteligencia de negocios y agentes orientados al cliente que necesitan respuestas fundamentadas. Ejecútalo con pip localmente, hospédalo tú mismo en Docker o en tus instalaciones, o migra a Cognee Cloud cuando desees escala gestionada. El proyecto reporta 30.4k estrellas en GitHub y más de 5M ejecuciones del SDK por mes, con despliegues en producción en Bayer y Knowunity.
wav2vec 2.0
¿Qué es wav2vec 2.0?
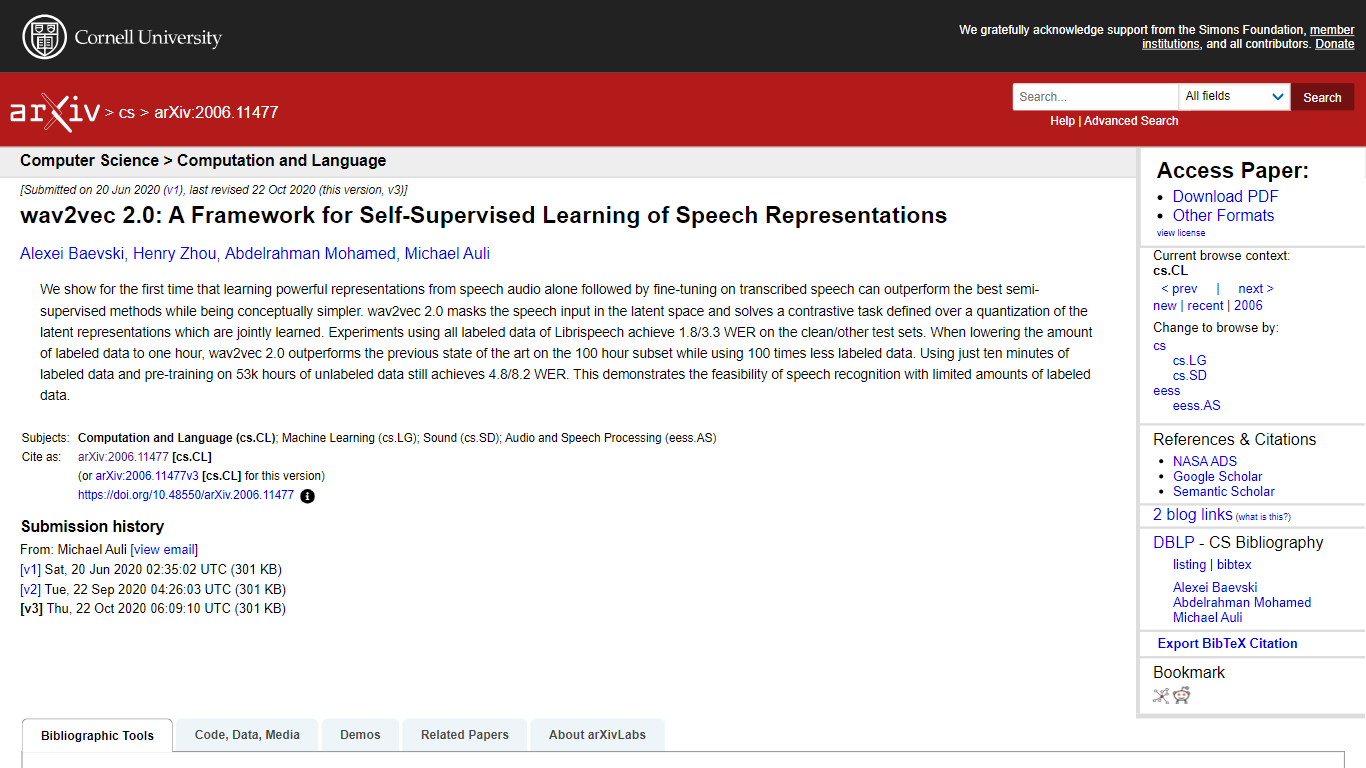
wav2vec 2.0 es un marco de aprendizaje auto-supervisado que aprende representaciones del habla directamente del audio en bruto. Enmascara porciones de la entrada de habla en un espacio latente y resuelve una tarea contrastiva sobre representaciones latentes cuantizadas, las cuales se aprenden conjuntamente con el modelo. Este enfoque permite que el modelo aproveche de manera efectiva grandes cantidades de datos de habla no etiquetados. Después de la pre-entrenamiento, wav2vec 2.0 puede ser ajustado finamente con pequeñas cantidades de datos de habla etiquetados para lograr un rendimiento de reconocimiento de voz de última generación. El modelo ha demostrado resultados sólidos incluso cuando se ajusta finamente con solo minutos de audio etiquetado, lo que lo hace altamente eficiente para escenarios de recursos limitados.
El marco simplifica el reconocimiento de voz eliminando la necesidad de pipelines complejos semi-supervisados, confiando en cambio en un único modelo de extremo a extremo. Logra tasas de error de palabra impresionantes en benchmarks estándar como Librispeech y TIMIT, superando métodos anteriores que requieren mucho más datos etiquetados. La cuantización de las representaciones latentes del habla permite que el modelo aprenda unidades discretas del habla, lo que mejora la robustez y la capacidad de generalización.
wav2vec 2.0 está dirigido a investigadores y desarrolladores que trabajan en reconocimiento de voz, especialmente aquellos interesados en aprovechar datos de audio no etiquetados para reducir los costos de anotación. Su capacidad para rendir bien con datos limitados etiquetados abre oportunidades para construir sistemas de voz en idiomas o dominios con recursos bajos. La arquitectura del modelo se basa en codificadores de características convolucionales y redes Transformer, lo que le permite capturar patrones de habla tanto locales como globales.
Técnicamente, wav2vec 2.0 combina aprendizaje contrastivo con una estrategia de enmascaramiento aplicada en el espacio latente, lo cual difiere de enfoques anteriores que enmascaran directamente el audio de entrada. Esta elección de diseño mejora la calidad de las representaciones aprendidas. El modelo se entrena en grandes conjuntos de datos no etiquetados, como 53,000 horas de habla, y se ajusta finamente en subconjuntos más pequeños etiquetados. Este proceso de entrenamiento en dos fases equilibra escalabilidad y precisión.
En resumen, wav2vec 2.0 representa un avance significativo en el aprendizaje de representaciones de habla auto-supervisado. Reduce la dependencia de datos etiquetados, simplifica las canalizaciones de entrenamiento y logra un rendimiento competitivo o superior en comparación con métodos completamente supervisados o semi-supervisados. La publicación del código y modelos preentrenados apoya la adopción y la investigación avanzada en tecnología del habla.
Cognee Votos positivos
wav2vec 2.0 Votos positivos
Cognee Características principales
pip install cognee conecta Claude Code, Codex o cualquier cliente MCP en minutos
recuerda, rememora, olvida y mejora como la API principal a través de SDK, HTTP y MCP
30.4k estrellas en GitHub y más de 5M de ejecuciones de SDK por mes listadas en la página principal
Enlaces de memoria híbrida de grafo y vector que conectan entidades en largas conversaciones y fuentes
El nivel gratuito de Cognee Cloud incluye 1M de tokens y un espacio de trabajo a $0 por mes
Ingesta desde Slack, Notion, Linear, Google Drive, S3 y repositorios de código en una capa de recuerdo
El benchmark BEAM 100K muestra que Cognee obtiene una puntuación de 0.79 en la página de resultados del SDK
wav2vec 2.0 Características principales
El preentrenamiento auto-supervisado en audio sin procesar 🎧 permite aprender de datos de voz sin etiquetar
El enmascaramiento en el espacio latente 🎭 mejora la concentración del modelo en el contexto y la robustez
La tarea contrastiva sobre representaciones cuantificadas 🔄 ayuda a aprender unidades discretas de voz
El ajuste fino con datos etiquetados mínimos 📝 logra una alta precisión en el reconocimiento de voz
La arquitectura basada en Transformer 🔗 captura eficazmente dependencias de voz a largo plazo
Cognee Categoría
- Large Language Model (LLM)
wav2vec 2.0 Categoría
- Large Language Model (LLM)
Cognee Tipo de tarificación
- Freemium
wav2vec 2.0 Tipo de tarificación
- Freemium