TLM Playground vs mshumer/gpt-prompt-engineer - GitHub
Sumérgete en la comparación de TLM Playground vs mshumer/gpt-prompt-engineer - GitHub y descubre cuál herramienta AI Model Generation se destaca. Analizamos alternativas, votos positivos, características, opiniones, precios, y más.
En una comparación entre TLM Playground y mshumer/gpt-prompt-engineer - GitHub, ¿cuál sale por encima?
Al comparar TLM Playground y mshumer/gpt-prompt-engineer - GitHub, dos herramientas excepcionales de la categoría de model generation impulsadas por inteligencia artificial, y colocarlas lado a lado, se destacan varias similitudes y diferencias clave. Ninguna de las herramientas toma la delantera, ya que ambas tienen el mismo número de votos positivos. Sé parte del proceso de toma de decisiones. Tu voto podría determinar al ganador.
¿El resultado te hace pensar "mmm"? ¡Emite tu voto y cambia esa expresión!
TLM Playground
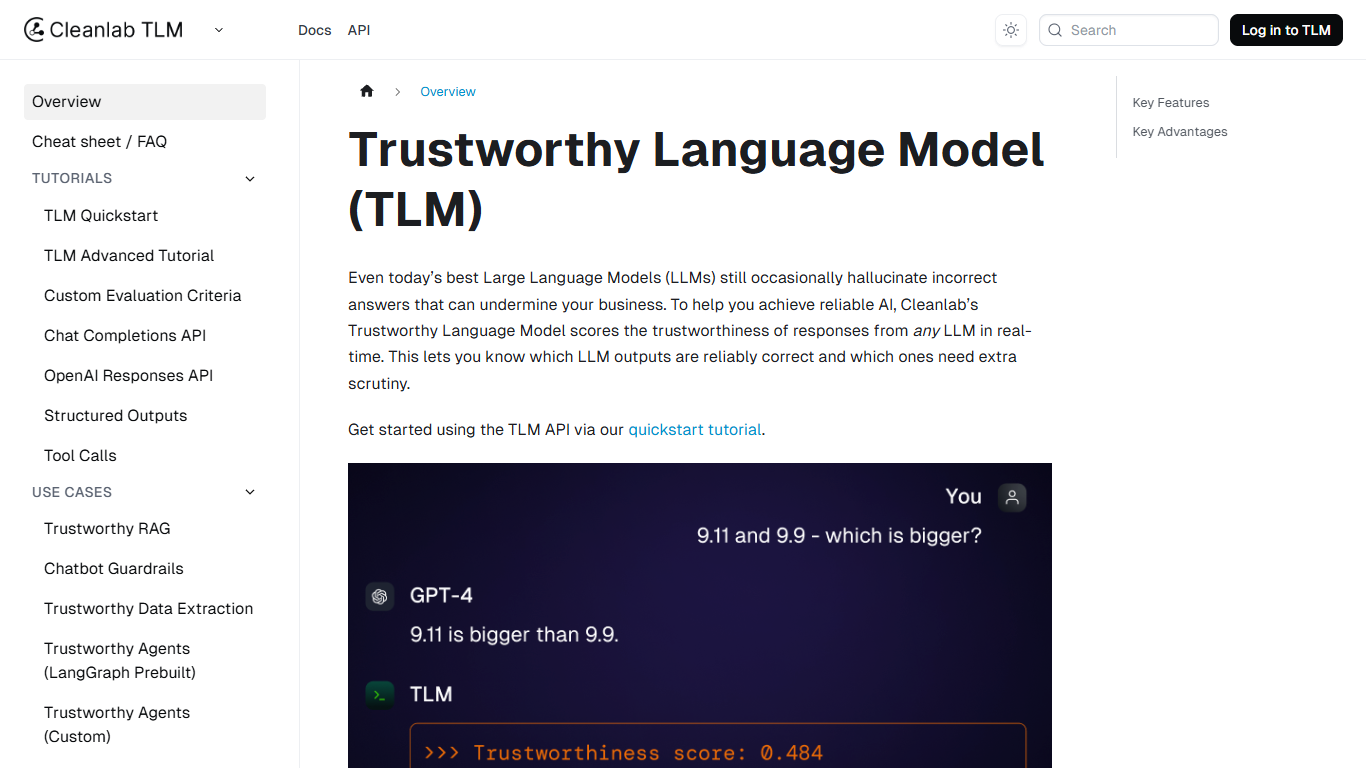

¿Qué es TLM Playground?
TLM Playground es el centro de documentación de Cleanlab para el Trustworthy Language Model (TLM), una API de generación de modelos que evalúa en tiempo real qué tan confiable es cualquier respuesta de un LLM. Cada respuesta recibe una puntuación de confiabilidad entre 0 y 1, señalando alucinaciones y errores de razonamiento antes de que lleguen a los usuarios. Instala el cliente de Python con pip install cleanlab-tlm, configura una CLEANLAB_TLM_API_KEY y llama a TLM.prompt() para generar respuestas puntuadas o a get_trustworthiness_score() para auditar salidas de tu stack existente.
La mayoría de los detectores de alucinaciones se enfocan en la fidelidad al contexto recuperado. Métricas como RAGAS verifican si una respuesta coincide con los documentos fuente pero no detectan errores factuales cuando el contexto es escaso o confuso. TLM utiliza estimación de incertidumbre del modelo en lugar de prompting con LLM como juez, y Cleanlab publica benchmarks que muestran una precisión 3 veces mayor que RAGAS en flujos de trabajo RAG. No requiere datos etiquetados en tu dominio, lo que evita el problema de deriva que afecta a evaluadores personalizados.
Ingenieros de ML y AI que construyen pipelines RAG, chatbots y sistemas de agentes usan TLM para filtrar salidas de baja confianza, redirigirlas a humanos o reemplazarlas con respuestas alternativas. La API cubre salidas estructuradas, llamadas a herramientas, etiquetas de clasificación y conversaciones de múltiples turnos, no solo completaciones de texto plano.
mshumer/gpt-prompt-engineer - GitHub
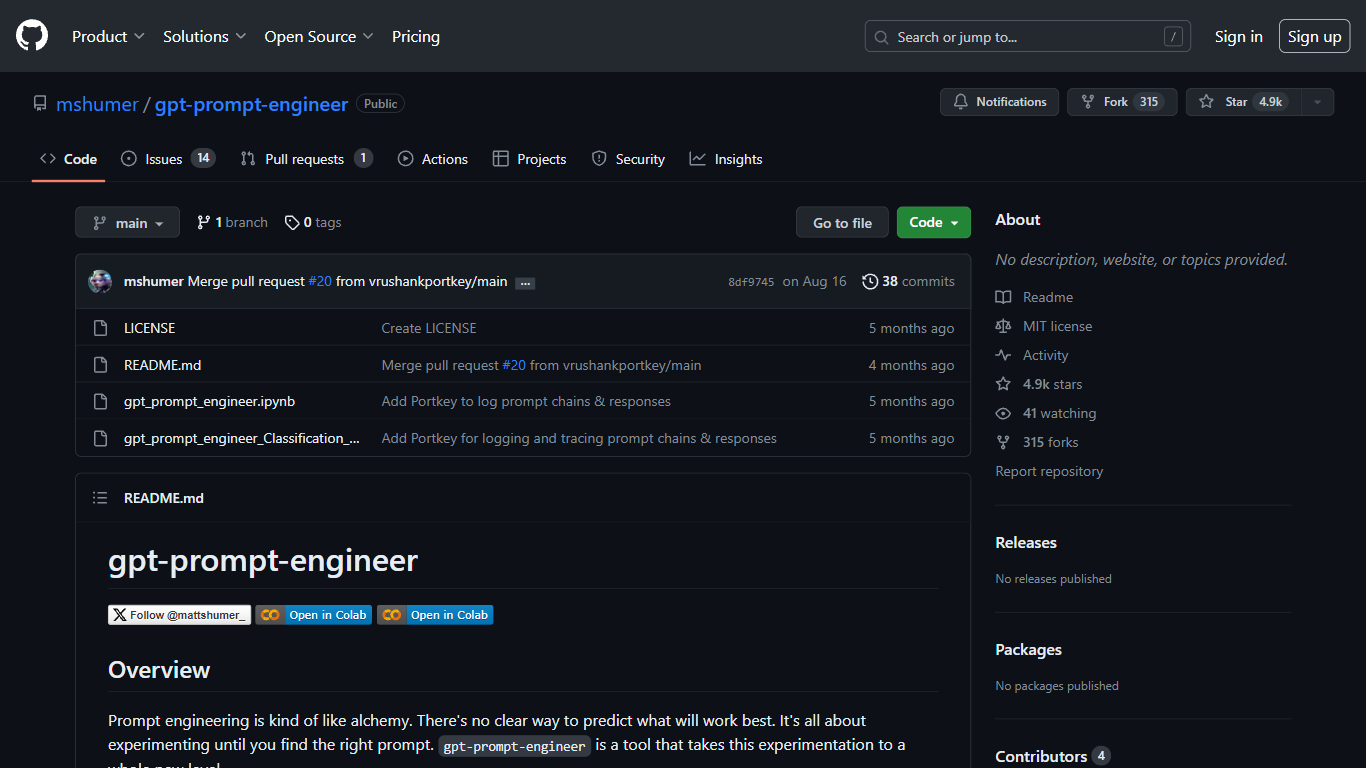
¿Qué es mshumer/gpt-prompt-engineer - GitHub?
mshumer/gpt-prompt-engineer es un kit de herramientas de ingeniería de prompts de código abierto que genera, prueba y clasifica prompts candidatos para una tarea que definas. Describes el caso de uso, proporcionas casos de prueba, y los cuadernos de Jupyter crean múltiples variantes de prompts, los ejecutan contra cada caso de prueba, y ordenan los resultados con un sistema de puntuación ELO que comienza en 1200. Se distribuye como cuadernos de Jupyter que puedes ejecutar en Google Colab o localmente.
La mayoría de las herramientas de prompts te ayudan a escribir un prompt a la vez. gpt-prompt-engineer trata la selección de prompts como un torneo: docenas de candidatos compiten en tus casos de prueba, y las puntuaciones ELO más altas revelan a los ganadores. Cuadernos separados cubren tareas de clasificación, Claude 3 Opus con casos de prueba generados automáticamente, y conversión de Opus a Haiku para inferencia más económica. El registro opcional con Weights & Biases y Portkey rastrea cada ejecución.
Los ingenieros de ML, ingenieros de prompts y desarrolladores de IA lo utilizan cuando necesitan ajustes reproducibles de prompts en lugar de prueba y error manual. El repositorio tiene 9.7k estrellas en GitHub y funciona con tus propias claves de API de OpenAI o Anthropic. Es gratuito bajo la licencia MIT.
TLM Playground Votos positivos
mshumer/gpt-prompt-engineer - GitHub Votos positivos
TLM Playground Características principales
Cada respuesta devuelve una puntuación de fiabilidad de 0 a 1 calculada mediante estimación de incertidumbre
get_trustworthiness_score() evalúa las salidas de cualquier LLM sin cambiar tu código de inferencia
TLM.prompt() devuelve tanto una respuesta como una puntuación en una sola llamada a la API, usando por defecto gpt-4.1-mini como modelo base
Los benchmarks reportan un 27% menos de respuestas incorrectas de GPT-4o y una detección de errores RAG 3 veces mejor que RAGAS
Los preajustes de calidad de bajo a alto, además de TLM Lite, te permiten intercambiar latencia y costo por profundidad de puntuación
TrustworthyRAG Evals evalúa la fundamentación, abstención y suficiencia del contexto junto con la fiabilidad
mshumer/gpt-prompt-engineer - GitHub Características principales
Genera múltiples candidatos de prompts a partir de una descripción de tarea y casos de prueba proporcionados por el usuario
Clasifica prompts con un sistema de puntuación ELO que comienza en 1200 por candidato
Soporta modelos GPT-4, GPT-3.5-Turbo y Claude 3 Opus como backend
Cuaderno de clasificación evalúa casos de prueba verdadero/falso e imprime una tabla de resultados
Cuaderno de Claude 3 genera automáticamente casos de prueba a partir de definiciones de variables de entrada
Cuaderno de conversión Opus-to-Haiku reduce latencia y costo manteniendo la calidad de salida
Registro opcional con Weights & Biases y Portkey para seguimiento de experimentos
TLM Playground Categoría
- Model Generation
mshumer/gpt-prompt-engineer - GitHub Categoría
- Model Generation
TLM Playground Tipo de tarificación
- Freemium
mshumer/gpt-prompt-engineer - GitHub Tipo de tarificación
- Free