AnyToSpeech vs MusicLM
Dans le choc de AnyToSpeech vs MusicLM, quel outil AI Audio Generation émerge victorieux? Nous évaluons les avis, les prix, les alternatives, les fonctionnalités, les votes positifs, et plus encore.
Quand nous mettons AnyToSpeech et MusicLM côte à côte, lequel émerge comme le vainqueur?
Prenons un plus près regard sur AnyToSpeech et MusicLM, tous deux étant des outils audio generation alimentés par l'IA, et voyons ce qui les distingue. Il n'y a pas de vainqueur clair en termes de votes positifs, car les deux outils ont reçu le même nombre. Votre vote compte ! Aidez-nous à décider du gagnant parmi les utilisateurs de aitools.fyi en votant.
Vous pensez que nous avons tort? Votez et montrez-nous qui est le patron!
AnyToSpeech
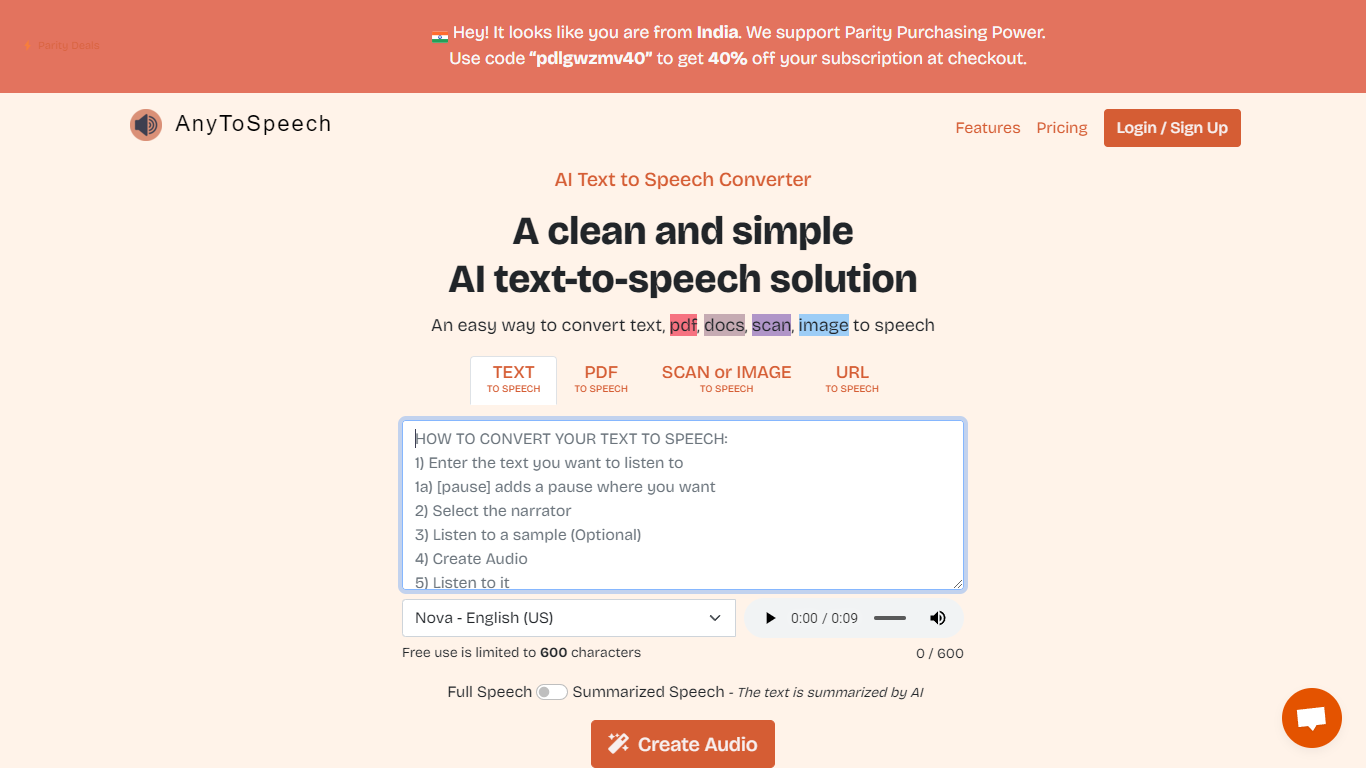

Qu'est-ce que AnyToSpeech?
AnyToSpeech est une plateforme en ligne de synthèse vocale qui transforme du contenu écrit en audio parlé. Collez du texte brut, téléchargez des PDFs, déposez des URL ou extraire du texte à partir d'images, et obtenez des fichiers MP3 avec des voix naturelles.
La plateforme va bien au-delà de la simple synthèse vocale basique. Vous pouvez créer des livres audio à partir de PDFs et de documents, narrer des pages web, réaliser des transcriptions speech-to-text, cloner votre voix à partir de courtes enregistrements, et générer des épisodes de podcast à deux voix à partir d’un brief ou d’un script. La conversion de PDF évite les numéros de page, les notes de bas de page et les sections de table des matières afin de maintenir un flux d’écoute fluide.
AnyToSpeech propose des centaines d’options de voix dans de nombreuses langues et accents, ainsi qu’un large ensemble d’outils d’analyse gratuits pour la prononciation, la détection d’accent et la notation vocale. Des applications mobiles sont disponibles sur Google Play et l’App Store d’Apple.
Elle convient aux créateurs, auteurs, éducateurs, et à tous ceux qui préfèrent écouter plutôt que lire.
MusicLM
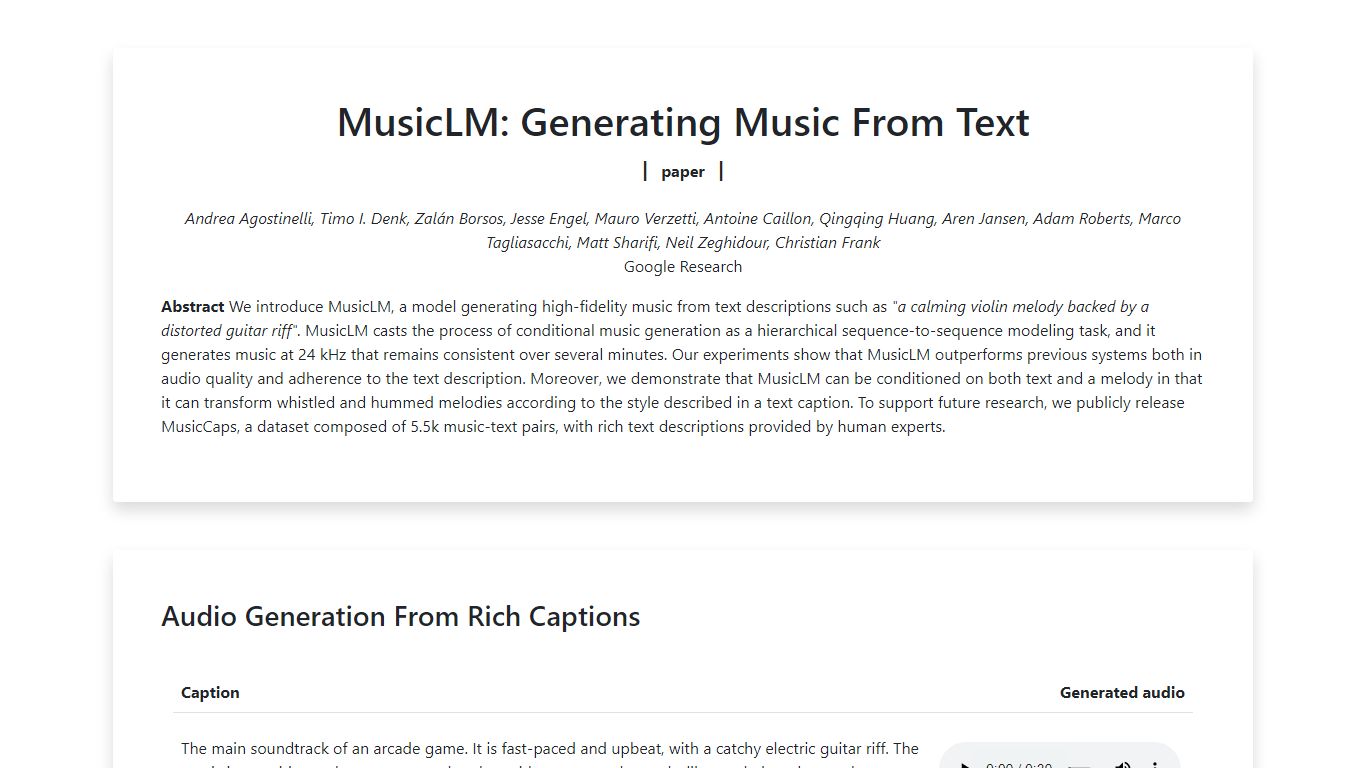
Qu'est-ce que MusicLM?
MusicLM est un modèle de génération audio de Google Research qui crée de la musique à partir de légendes textuelles à 24 kHz. La page d'exemples publics héberge des extraits pour des invites telles que des bandes-son d'arcade, des fusions reggaeton-EDM et du jazz relaxant, ainsi que des générations plus longues en mode histoire qui changent de style selon des segments temporels. Google a publié le jeu de données MusicCaps de 5 500 paires musique-texte en même temps que l'article.
Contrairement aux applications grand public qui proposent une seule zone de saisie, MusicLM a été publié comme une démo de recherche avec des échantillons pré-générés plutôt qu'un produit nécessitant une connexion. Son astuce principale est la condition conjointe texte et mélodie : vous pouvez fredonner ou siffler un air et le modèle le recompose dans un nouveau genre décrit par texte. Le mode histoire enchaîne plusieurs légendes pour que la musique évolue au fil des sections.
MusicLM est important comme base de recherche derrière les modèles musicaux Lyria ultérieurs de Google, mais cette page sert à écouter des exemples publiés, pas à créer de nouveaux morceaux de manière interactive. Chercheurs et musiciens l'étudient pour la cohérence sur le long terme, la condition peinture-à-musique et les résultats de transfert de mélodie documentés dans l'article de 2023.
AnyToSpeech Votes positifs
MusicLM Votes positifs
AnyToSpeech Fonctionnalités principales
Collez du texte ou téléchargez des PDF, DOCX, et URL, puis téléchargez un audio MP3 soigné avec un rythme de parole ajustable
Clonez votre voix à partir de trois courts enregistrements en environ 30 secondes et utilisez-la dans tous les outils de conversion
Générez des épisodes de podcast à deux voix à partir d'un sujet ou d'un script, avec musique d'introduction et titre parlé
Téléchargez des fichiers audio ou vidéo pour une transcription que vous pouvez traduire en plus de 100 langues, avec 50 minutes gratuites chaque mois
Choisissez parmi des centaines de voix dans plus de 24 langues d'interface, y compris des accents spécifiques à chaque région dans le monde
MusicLM Fonctionnalités principales
Génère de la musique à 24 kHz à partir de légendes en texte enrichi
Le mode histoire enchaîne plusieurs invites de texte sur des segments chronométrés
La conditionnement texte-et-mélodie transforme des airs sifflés ou fredonnés en nouveaux styles
Le conditionnement de légendes de peinture associe descriptions d'œuvres d'art et audio généré
Les exemples de longue génération couvrent le techno mélodique, le swing et le jazz relaxant
Le dataset MusicCaps comprend 5 500 paires musique-texte annotées par des experts
AnyToSpeech Catégorie
- Audio Generation
MusicLM Catégorie
- Audio Generation
AnyToSpeech Type de tarification
- Freemium
MusicLM Type de tarification
- Free