Moshi AI vs AnyToSpeech
Dans le choc de Moshi AI vs AnyToSpeech, quel outil AI Audio Generation émerge victorieux? Nous évaluons les avis, les prix, les alternatives, les fonctionnalités, les votes positifs, et plus encore.
Quand nous mettons Moshi AI et AnyToSpeech côte à côte, lequel émerge comme le vainqueur?
Prenons un plus près regard sur Moshi AI et AnyToSpeech, tous deux étant des outils audio generation alimentés par l'IA, et voyons ce qui les distingue. Aucun outil ne prend l'avantage, car ils ont tous deux le même nombre de votes positifs. Le pouvoir est entre vos mains ! Votez et participez à la décision du gagnant.
Pas votre tasse de thé? Votez pour votre outil préféré et remuez les choses!
Moshi AI
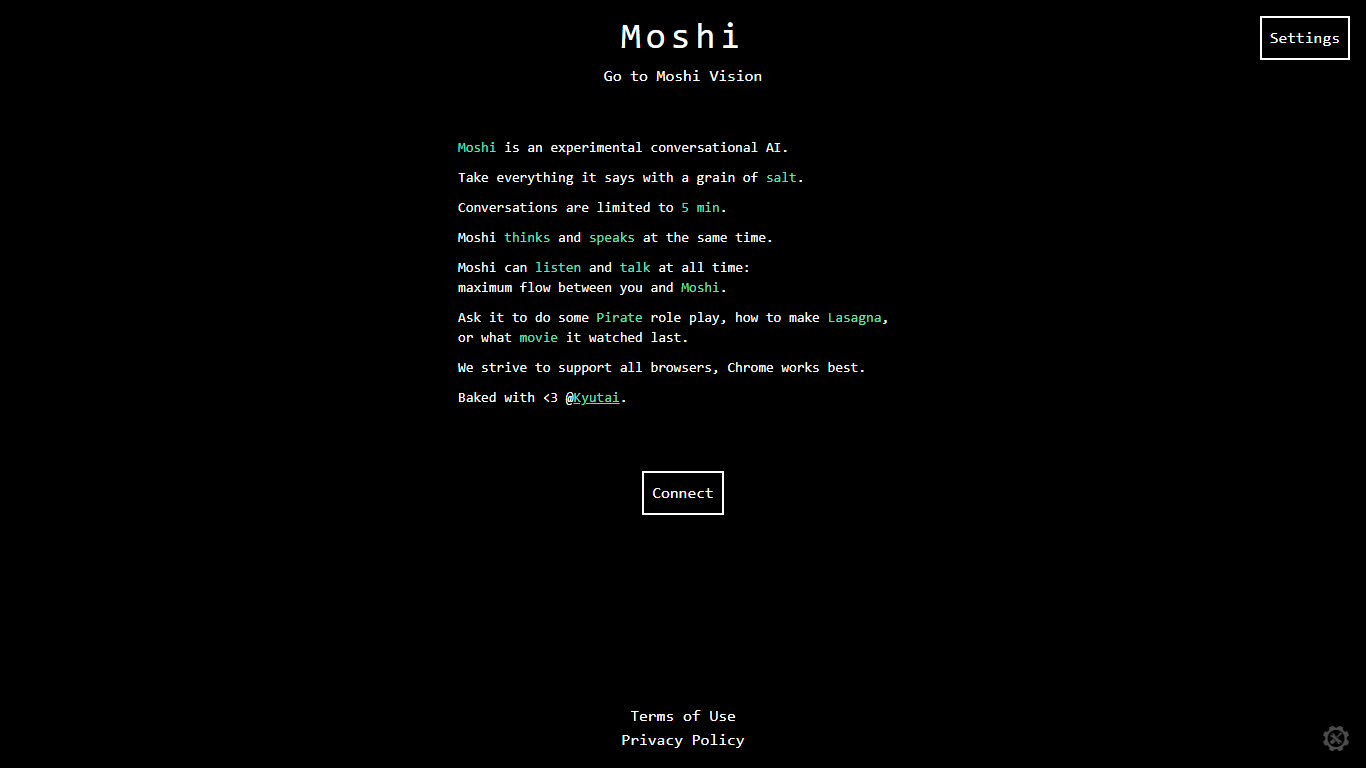

Qu'est-ce que Moshi AI?
Moshi AI est un modèle conversationnel natif à la parole développé par Kyutai, un laboratoire de recherche open-science basé à Paris. Au lieu de chaîner la reconnaissance vocale, la génération de texte et la synthèse vocale, Moshi traite directement l'audio et mène des conversations vocales en duplex intégral avec une latence minimale.
Sa conception multi-flux exécute des canaux séparés pour l'utilisateur, la sortie vocale de Moshi, et un flux de texte Monologue intérieur qui améliore la cohérence. Cette configuration permet à Moshi d'écouter et de parler en même temps, de gérer les chevauchements, les interruptions et la réponse en arrière-plan comme lors d'une vraie conversation, plutôt que des tours de parole rigides.
Moshi est construit sur Helium, un modèle linguistique de 7 milliards de paramètres, et Mimi, le codec audio neuronal de Kyutai. Les poids et le code d'inférence sont disponibles pour PyTorch, Rust, et MLX, et vous pouvez l'essayer dans le navigateur sur moshi-chat.kyutai.org. Les chercheurs, les développeurs d'IA vocale, et toute personne créant des interfaces vocales en temps réel y trouveront le plus de valeur.
AnyToSpeech
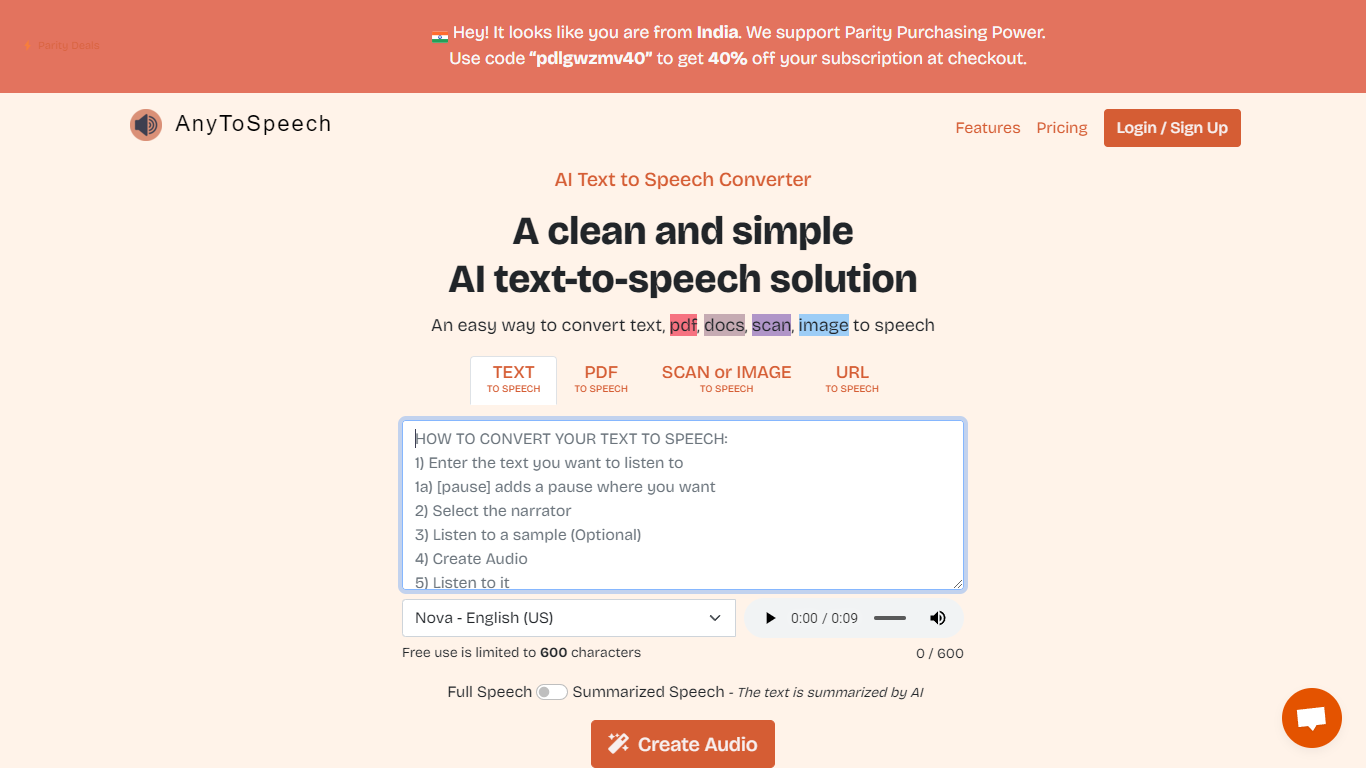
Qu'est-ce que AnyToSpeech?
AnyToSpeech est une plateforme en ligne de synthèse vocale qui transforme du contenu écrit en audio parlé. Collez du texte brut, téléchargez des PDFs, déposez des URL ou extraire du texte à partir d'images, et obtenez des fichiers MP3 avec des voix naturelles.
La plateforme va bien au-delà de la simple synthèse vocale basique. Vous pouvez créer des livres audio à partir de PDFs et de documents, narrer des pages web, réaliser des transcriptions speech-to-text, cloner votre voix à partir de courtes enregistrements, et générer des épisodes de podcast à deux voix à partir d’un brief ou d’un script. La conversion de PDF évite les numéros de page, les notes de bas de page et les sections de table des matières afin de maintenir un flux d’écoute fluide.
AnyToSpeech propose des centaines d’options de voix dans de nombreuses langues et accents, ainsi qu’un large ensemble d’outils d’analyse gratuits pour la prononciation, la détection d’accent et la notation vocale. Des applications mobiles sont disponibles sur Google Play et l’App Store d’Apple.
Elle convient aux créateurs, auteurs, éducateurs, et à tous ceux qui préfèrent écouter plutôt que lire.
Moshi AI Votes positifs
AnyToSpeech Votes positifs
Moshi AI Fonctionnalités principales
Traite la parole directement sans pipeline de texte intermédiaire
Écoute et parle simultanément avec prise en charge du chevauchement et de l'interruption
Le flux de texte Inner Monologue améliore la qualité de la parole et le raisonnement
Fonctionne en temps réel sur un GPU L4 ou un MacBook Pro M3 via le codec Mimi
Poids ouverts sur Hugging Face avec PyTorch, Rust et code d'inférence MLX
AnyToSpeech Fonctionnalités principales
Collez du texte ou téléchargez des PDF, DOCX, et URL, puis téléchargez un audio MP3 soigné avec un rythme de parole ajustable
Clonez votre voix à partir de trois courts enregistrements en environ 30 secondes et utilisez-la dans tous les outils de conversion
Générez des épisodes de podcast à deux voix à partir d'un sujet ou d'un script, avec musique d'introduction et titre parlé
Téléchargez des fichiers audio ou vidéo pour une transcription que vous pouvez traduire en plus de 100 langues, avec 50 minutes gratuites chaque mois
Choisissez parmi des centaines de voix dans plus de 24 langues d'interface, y compris des accents spécifiques à chaque région dans le monde
Moshi AI Catégorie
- Audio Generation
AnyToSpeech Catégorie
- Audio Generation
Moshi AI Type de tarification
- Free
AnyToSpeech Type de tarification
- Freemium