Moshi AI vs MusicLM
Lors de la comparaison de Moshi AI vs MusicLM, quel outil AI Audio Generation brille le plus? Nous examinons les prix, les alternatives, les votes positifs, les fonctionnalités, les avis, et bien plus.
Dans une comparaison entre Moshi AI et MusicLM, lequel sort vainqueur?
Quand nous mettons Moshi AI et MusicLM côte à côte, tous deux étant des outils audio generation alimentés par l'IA, Le décompte des votes positifs est au coude à coude pour Moshi AI et MusicLM. Chaque vote compte ! Faites le vôtre et contribuez à la décision du gagnant.
Vous n'êtes pas d'accord avec le résultat? Votez pour votre outil préféré et aidez-le à gagner!
Moshi AI

Qu'est-ce que Moshi AI?
Moshi AI est un modèle conversationnel natif à la parole développé par Kyutai, un laboratoire de recherche open-science basé à Paris. Au lieu de chaîner la reconnaissance vocale, la génération de texte et la synthèse vocale, Moshi traite directement l'audio et mène des conversations vocales en duplex intégral avec une latence minimale.
Sa conception multi-flux exécute des canaux séparés pour l'utilisateur, la sortie vocale de Moshi, et un flux de texte Monologue intérieur qui améliore la cohérence. Cette configuration permet à Moshi d'écouter et de parler en même temps, de gérer les chevauchements, les interruptions et la réponse en arrière-plan comme lors d'une vraie conversation, plutôt que des tours de parole rigides.
Moshi est construit sur Helium, un modèle linguistique de 7 milliards de paramètres, et Mimi, le codec audio neuronal de Kyutai. Les poids et le code d'inférence sont disponibles pour PyTorch, Rust, et MLX, et vous pouvez l'essayer dans le navigateur sur moshi-chat.kyutai.org. Les chercheurs, les développeurs d'IA vocale, et toute personne créant des interfaces vocales en temps réel y trouveront le plus de valeur.
MusicLM
Qu'est-ce que MusicLM?
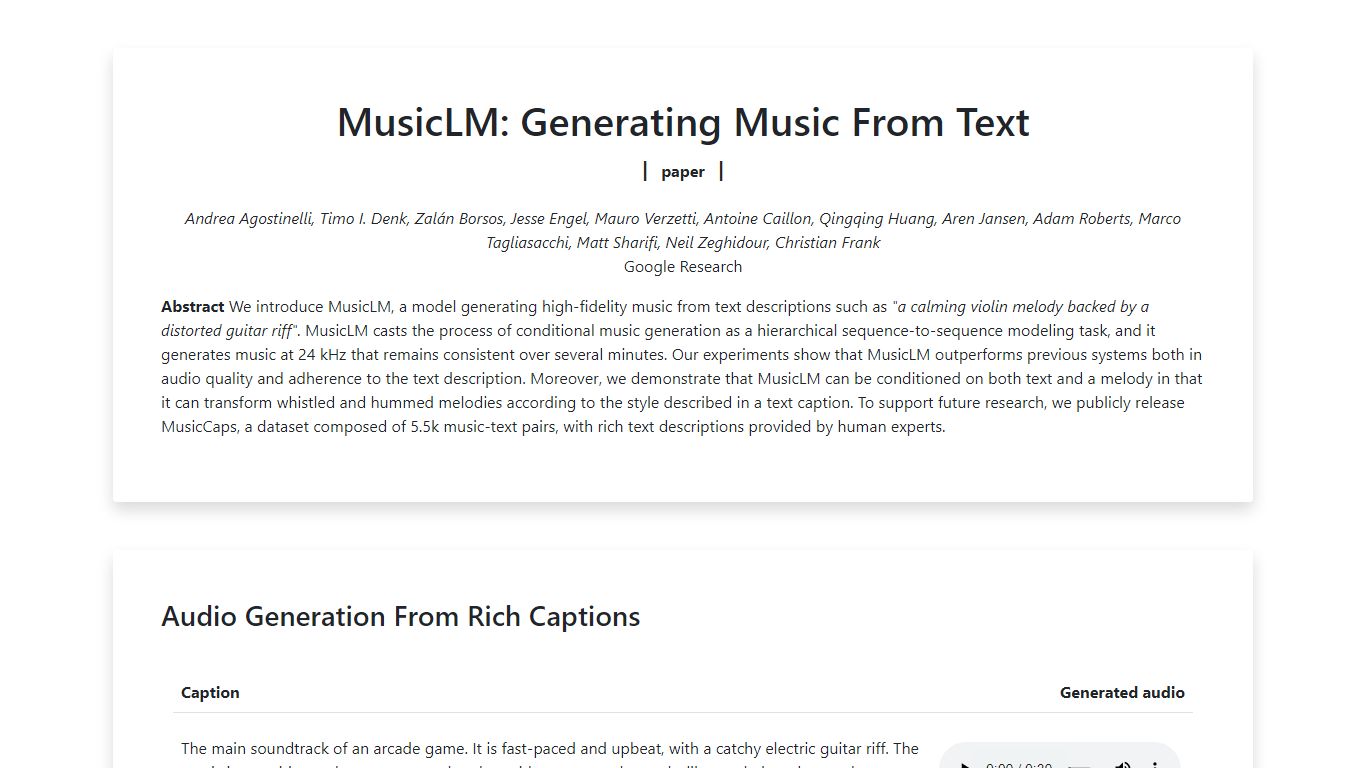
MusicLM est un modèle de génération audio de Google Research qui crée de la musique à partir de légendes textuelles à 24 kHz. La page d'exemples publics héberge des extraits pour des invites telles que des bandes-son d'arcade, des fusions reggaeton-EDM et du jazz relaxant, ainsi que des générations plus longues en mode histoire qui changent de style selon des segments temporels. Google a publié le jeu de données MusicCaps de 5 500 paires musique-texte en même temps que l'article.
Contrairement aux applications grand public qui proposent une seule zone de saisie, MusicLM a été publié comme une démo de recherche avec des échantillons pré-générés plutôt qu'un produit nécessitant une connexion. Son astuce principale est la condition conjointe texte et mélodie : vous pouvez fredonner ou siffler un air et le modèle le recompose dans un nouveau genre décrit par texte. Le mode histoire enchaîne plusieurs légendes pour que la musique évolue au fil des sections.
MusicLM est important comme base de recherche derrière les modèles musicaux Lyria ultérieurs de Google, mais cette page sert à écouter des exemples publiés, pas à créer de nouveaux morceaux de manière interactive. Chercheurs et musiciens l'étudient pour la cohérence sur le long terme, la condition peinture-à-musique et les résultats de transfert de mélodie documentés dans l'article de 2023.
Moshi AI Votes positifs
MusicLM Votes positifs
Moshi AI Fonctionnalités principales
Traite la parole directement sans pipeline de texte intermédiaire
Écoute et parle simultanément avec prise en charge du chevauchement et de l'interruption
Le flux de texte Inner Monologue améliore la qualité de la parole et le raisonnement
Fonctionne en temps réel sur un GPU L4 ou un MacBook Pro M3 via le codec Mimi
Poids ouverts sur Hugging Face avec PyTorch, Rust et code d'inférence MLX
MusicLM Fonctionnalités principales
Génère de la musique à 24 kHz à partir de légendes en texte enrichi
Le mode histoire enchaîne plusieurs invites de texte sur des segments chronométrés
La conditionnement texte-et-mélodie transforme des airs sifflés ou fredonnés en nouveaux styles
Le conditionnement de légendes de peinture associe descriptions d'œuvres d'art et audio généré
Les exemples de longue génération couvrent le techno mélodique, le swing et le jazz relaxant
Le dataset MusicCaps comprend 5 500 paires musique-texte annotées par des experts
Moshi AI Catégorie
- Audio Generation
MusicLM Catégorie
- Audio Generation
Moshi AI Type de tarification
- Free
MusicLM Type de tarification
- Free