TLM Playground vs Fal AI
Dans le concours de TLM Playground vs Fal AI, quel outil AI Model Generation est le champion? Nous évaluons les prix, les alternatives, les votes positifs, les fonctionnalités, les avis, et plus encore.
Si vous deviez choisir entre TLM Playground et Fal AI, lequel préféreriez-vous?
Lorsque nous examinons TLM Playground et Fal AI, tous deux étant des outils model generation alimentés par l'IA, quelles caractéristiques uniques découvrons-nous ? Le décompte des votes positifs est au coude à coude pour TLM Playground et Fal AI. Puisque d'autres utilisateurs de aitools.fyi pourraient décider du gagnant, c'est maintenant à vous de jouer pour voter et nous aider à déterminer le gagnant.
Vous n'êtes pas d'accord avec le résultat? Votez pour nous aider à décider!
TLM Playground

Qu'est-ce que TLM Playground?
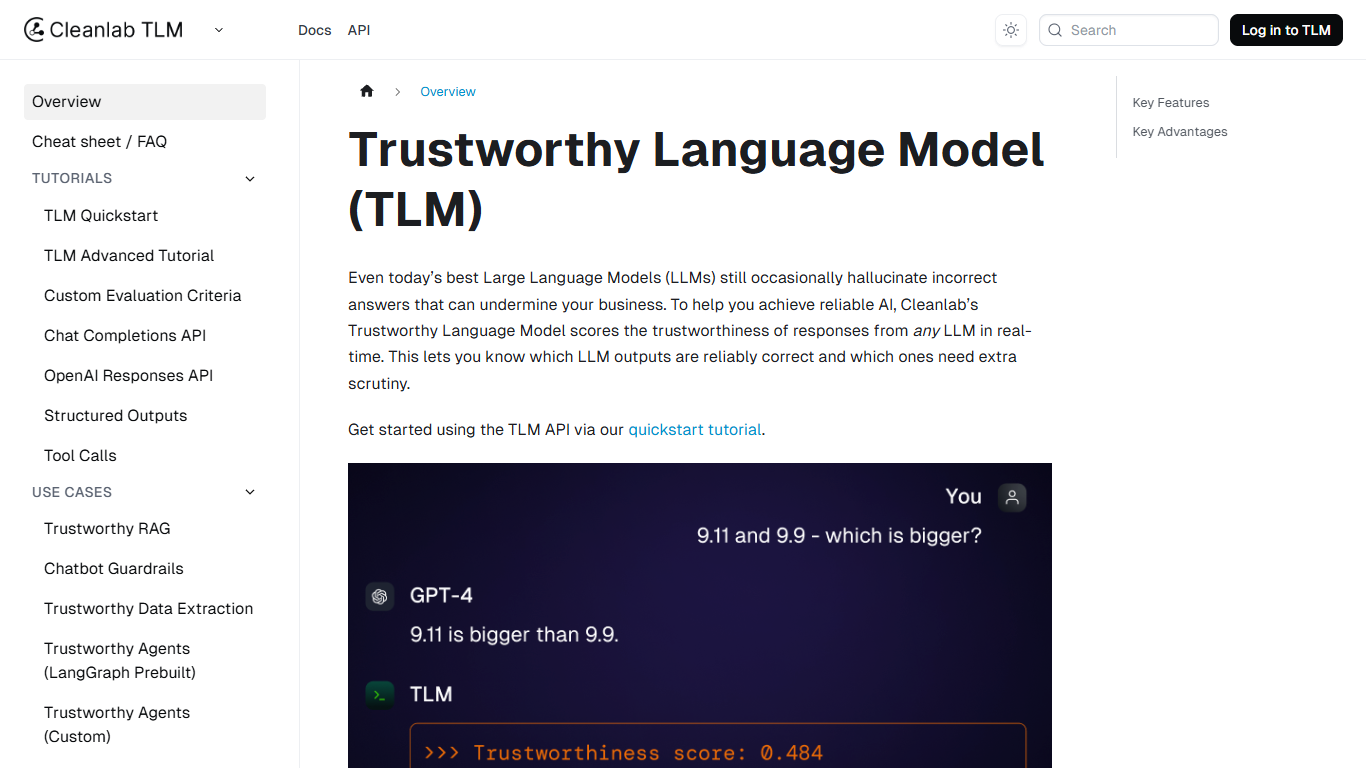
TLM Playground est le centre de documentation de Cleanlab pour le Trustworthy Language Model (TLM), une API de génération de modèles qui évalue en temps réel la fiabilité de toute réponse d'un LLM. Chaque réponse reçoit un score de fiabilité compris entre 0 et 1, signalant les hallucinations et erreurs de raisonnement avant qu'elles n'atteignent les utilisateurs. Installez le client Python avec pip install cleanlab-tlm, définissez une CLEANLAB_TLM_API_KEY, et appelez TLM.prompt() pour générer des réponses notées ou get_trustworthiness_score() pour auditer les sorties de votre pile existante.
La plupart des détecteurs d'hallucinations se concentrent sur la fidélité au contexte récupéré. Des métriques comme RAGAS vérifient si une réponse correspond aux documents sources mais manquent les erreurs factuelles lorsque le contexte est mince ou confus. TLM utilise l'estimation de l'incertitude du modèle plutôt que le prompting LLM-en-juge, et Cleanlab publie des benchmarks montrant une précision 3 fois supérieure à RAGAS dans les workflows RAG. Il ne nécessite pas de données d'entraînement étiquetées dans votre domaine, ce qui évite le problème de dérive qui compromet les évaluateurs personnalisés.
Les ingénieurs ML et IA construisant des pipelines RAG, chatbots et systèmes d'agents utilisent TLM pour filtrer les sorties à faible confiance, les orienter vers des humains, ou remplacer par des réponses de secours. L'API couvre les sorties structurées, les appels d'outils, les étiquettes de classification et les conversations multi-tours, pas seulement les complétions de texte simples.
Fal AI
Qu'est-ce que Fal AI?
Fal AI héberge plus de 1 000 modèles génératifs multimédias derrière une seule API pour la génération d'images, de vidéos, d'audios et de contenus 3D. Les développeurs appellent des modèles comme Flux, Kling, Wan et Seedream via des points de terminaison REST ou des SDK sans avoir à provisionner leurs propres GPU. Chaque page de modèle affiche son prix par génération à l'avance, et vous ne payez que pour les générations réussies.
Replicate et Hugging Face Inference se concentrent sur des modèles à poids ouverts avec facturation par seconde de GPU. Fal AI mise sur des modèles multimédias frontaliers sélectionnés avec une tarification basée sur la sortie : environ 0,03 $ par image pour Seedream V4 ou 0,05 $ par seconde de vidéo Wan 2.5. Les équipes ayant besoin de poids personnalisés peuvent déployer des GPU serverless sur Fal à partir de 1,89 $ par heure pour un H100.
Les créateurs d'applications, les outils créatifs et les startups médias qui souhaitent des API génératives prêtes pour la production sans gérer leur propre infrastructure d'inférence sont les principaux utilisateurs. Il n'y a pas d'abonnement ; vous ajoutez des crédits prépayés et ajustez votre utilisation selon vos besoins.
TLM Playground Votes positifs
Fal AI Votes positifs
TLM Playground Fonctionnalités principales
Chaque réponse retourne un score de fiabilité de 0 à 1 calculé via une estimation de l'incertitude
get_trustworthiness_score() évalue les résultats de n'importe quel LLM sans modifier votre code d'inférence
TLM.prompt() retourne à la fois une réponse et un score en un seul appel API, en utilisant par défaut gpt-4.1-mini comme modèle de base
Les benchmarks rapportent 27% de réponses GPT-4o incorrectes en moins et une détection d'erreurs RAG 3 fois meilleure que RAGAS
Les préréglages de qualité, de faible à élevée, plus TLM Lite, vous permettent d'échanger la latence et le coût contre la profondeur de l'évaluation
TrustworthyRAG Evals évalue la solidité, l'abstention et la suffisance du contexte en plus de la fiabilité
Fal AI Fonctionnalités principales
Plus de 1 000 modèles hébergés couvrant la génération d'images, de vidéos, d'audio et de 3D
Tarification basée sur la sortie comme 0,03 $ par image ou 0,05 $ par seconde de vidéo
Déploiements GPU sans serveur à partir de 1,89 $ par heure pour H100 80 Go
API REST unifiée et SDK avec file d'attente et streaming
Affinement personnalisé LoRA et clusters de calcul H100, H200 et B200 à la demande
Payez uniquement pour les sorties réussies ; pas de frais pour les erreurs serveur ou le temps d'attente en file d'attente
TLM Playground Catégorie
- Model Generation
Fal AI Catégorie
- Model Generation
TLM Playground Type de tarification
- Freemium
Fal AI Type de tarification
- Paid