TLM Playground vs Plumb
Dans le choc de TLM Playground vs Plumb, quel outil AI Model Generation émerge victorieux? Nous évaluons les avis, les prix, les alternatives, les fonctionnalités, les votes positifs, et plus encore.
Quand nous mettons TLM Playground et Plumb côte à côte, lequel émerge comme le vainqueur?
Prenons un plus près regard sur TLM Playground et Plumb, tous deux étant des outils model generation alimentés par l'IA, et voyons ce qui les distingue. Les deux outils sont également favorisés, comme l'indique le décompte identique des votes positifs. Rejoignez les utilisateurs de aitools.fyi pour décider du gagnant en votant.
Le résultat vous fait dire "hmm"? Votez et transformez cette grimace en sourire!
TLM Playground

Qu'est-ce que TLM Playground?
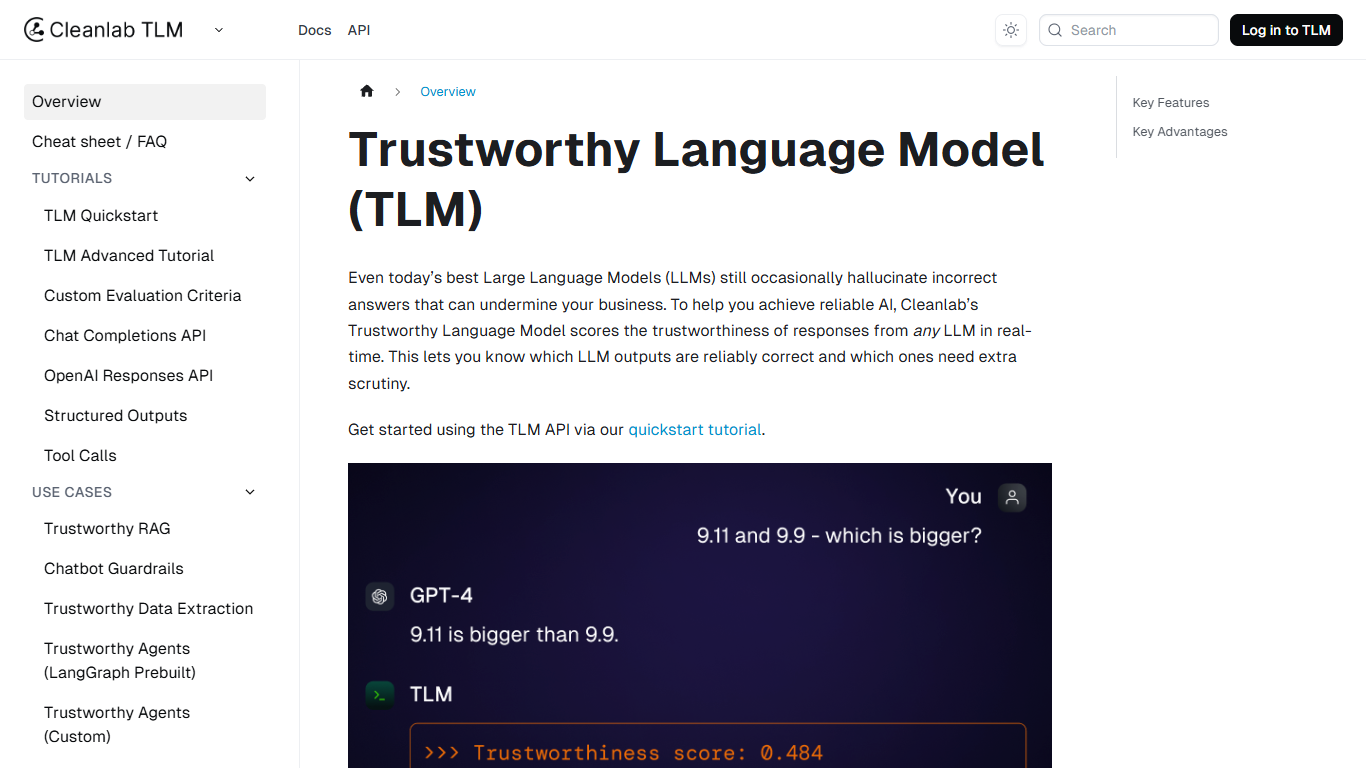
TLM Playground est le centre de documentation de Cleanlab pour le Trustworthy Language Model (TLM), une API de génération de modèles qui évalue en temps réel la fiabilité de toute réponse d'un LLM. Chaque réponse reçoit un score de fiabilité compris entre 0 et 1, signalant les hallucinations et erreurs de raisonnement avant qu'elles n'atteignent les utilisateurs. Installez le client Python avec pip install cleanlab-tlm, définissez une CLEANLAB_TLM_API_KEY, et appelez TLM.prompt() pour générer des réponses notées ou get_trustworthiness_score() pour auditer les sorties de votre pile existante.
La plupart des détecteurs d'hallucinations se concentrent sur la fidélité au contexte récupéré. Des métriques comme RAGAS vérifient si une réponse correspond aux documents sources mais manquent les erreurs factuelles lorsque le contexte est mince ou confus. TLM utilise l'estimation de l'incertitude du modèle plutôt que le prompting LLM-en-juge, et Cleanlab publie des benchmarks montrant une précision 3 fois supérieure à RAGAS dans les workflows RAG. Il ne nécessite pas de données d'entraînement étiquetées dans votre domaine, ce qui évite le problème de dérive qui compromet les évaluateurs personnalisés.
Les ingénieurs ML et IA construisant des pipelines RAG, chatbots et systèmes d'agents utilisent TLM pour filtrer les sorties à faible confiance, les orienter vers des humains, ou remplacer par des réponses de secours. L'API couvre les sorties structurées, les appels d'outils, les étiquettes de classification et les conversations multi-tours, pas seulement les complétions de texte simples.
Plumb

Qu'est-ce que Plumb?
Plumb permet aux consultants en IA de créer, déployer et vendre des workflows autonomes à partir d'un éditeur visuel de nœuds sans écrire de code. Chaque flux dispose de sa propre interface, fonctionne à la demande ou en mode automatique, et accepte des entrées textuelles, audio, images et vidéo. L'accès se fait via une demande en bêta privée sur signup.useplumb.com.
Là où les outils génériques de workflow s'arrêtent aux tâches internes, Plumb cible les personnes qui vendent des travaux en IA. Vous pouvez publier des flux, pousser des mises à jour sans cloner de copies, définir des barrières payantes avec des frais uniques, des abonnements ou des frais par exécution, et partager des pages promotionnelles. Cette couche de monétisation axée sur le consultant est la principale différence avec les suites d'automatisation no-code générales.
Les consultants IA indépendants, les équipes d'agence et les responsables internes qui prototypent des pipelines de modèles multimodaux sont les mieux adaptés. Les flux se ramifient selon des conditions et dirigent les sorties vers email, SMS ou Slack.
TLM Playground Votes positifs
Plumb Votes positifs
TLM Playground Fonctionnalités principales
Chaque réponse retourne un score de fiabilité de 0 à 1 calculé via une estimation de l'incertitude
get_trustworthiness_score() évalue les résultats de n'importe quel LLM sans modifier votre code d'inférence
TLM.prompt() retourne à la fois une réponse et un score en un seul appel API, en utilisant par défaut gpt-4.1-mini comme modèle de base
Les benchmarks rapportent 27% de réponses GPT-4o incorrectes en moins et une détection d'erreurs RAG 3 fois meilleure que RAGAS
Les préréglages de qualité, de faible à élevée, plus TLM Lite, vous permettent d'échanger la latence et le coût contre la profondeur de l'évaluation
TrustworthyRAG Evals évalue la solidité, l'abstention et la suffisance du contexte en plus de la fiabilité
Plumb Fonctionnalités principales
Le niveau gratuit comprend 50 exécutions et 200 crédits IA à 0 $ par mois pour un utilisateur
Le plan Pro à 49 $ par mois inclut 500 exécutions et 2 000 crédits IA pour un utilisateur
Le plan Équipe à 249 $ par mois supporte un nombre illimité d'utilisateurs avec 2 000 exécutions par mois
Nœuds intégrés pour Perplexity, Exa, OpenAI, Anthropic, ElevenLabs et AssemblyAI
Chaque flux est livré avec sa propre interface frontale plus une approbation humaine en option
Le contrôle de version suit les modifications, et la publication pousse les mises à jour à tous les utilisateurs liés
Sortie de schéma JSON structuré à chaque étape IA pour des données fiables en aval
TLM Playground Catégorie
- Model Generation
Plumb Catégorie
- Model Generation
TLM Playground Type de tarification
- Freemium
Plumb Type de tarification
- Freemium