TLM Playground vs ZenPrompts
Dans le duel entre TLM Playground vs ZenPrompts, quel outil AI Model Generation prend la couronne? Nous scrutons les fonctionnalités, les alternatives, les votes positifs, les avis, les prix, et plus encore.
Dans un face-à-face entre TLM Playground et ZenPrompts, lequel prend la couronne?
Si nous devions analyser TLM Playground et ZenPrompts, tous deux étant des outils model generation alimentés par l'IA, que trouverions-nous ? Fait intéressant, les deux outils ont réussi à obtenir le même nombre de votes positifs. Votre vote compte ! Aidez-nous à décider du gagnant parmi les utilisateurs de aitools.fyi en votant.
Vous vous sentez rebelle? Votez et secouez les choses!
TLM Playground

Qu'est-ce que TLM Playground?
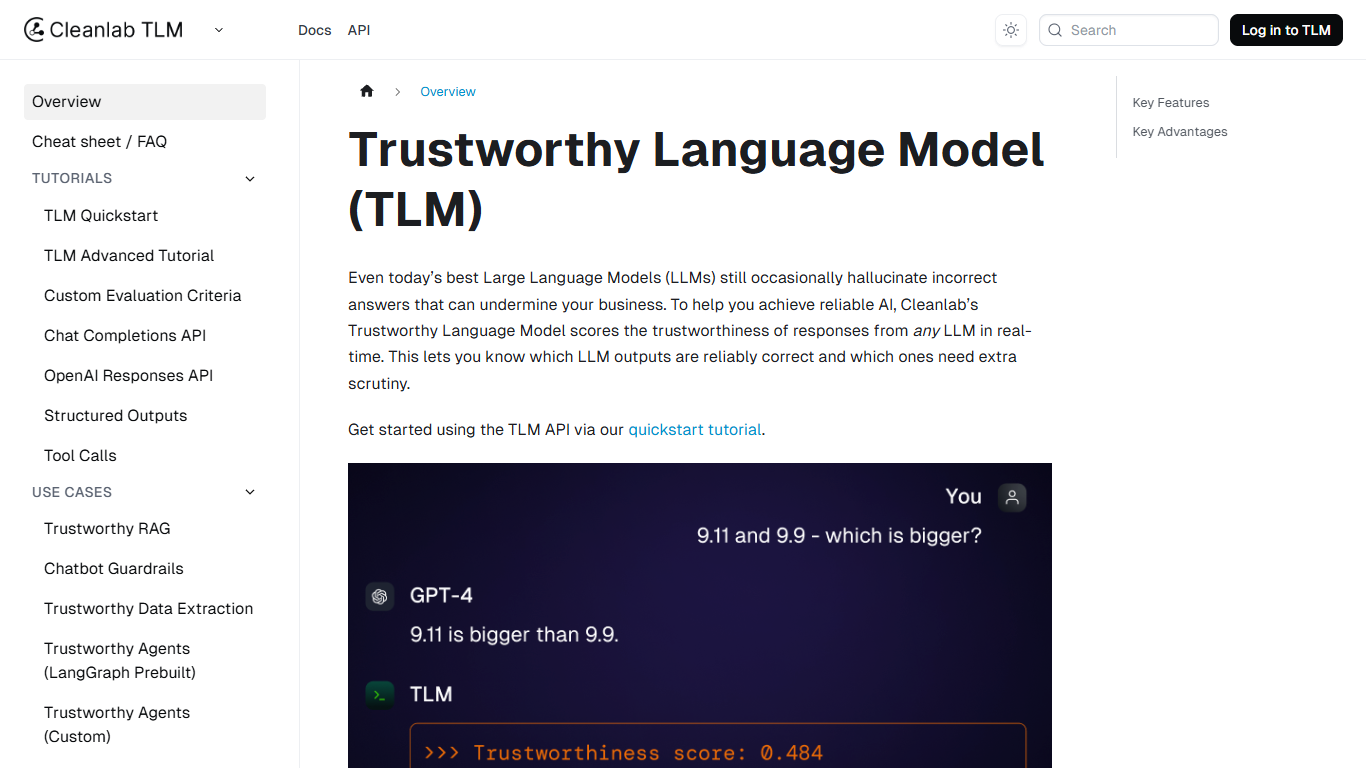
TLM Playground est le centre de documentation de Cleanlab pour le Trustworthy Language Model (TLM), une API de génération de modèles qui évalue en temps réel la fiabilité de toute réponse d'un LLM. Chaque réponse reçoit un score de fiabilité compris entre 0 et 1, signalant les hallucinations et erreurs de raisonnement avant qu'elles n'atteignent les utilisateurs. Installez le client Python avec pip install cleanlab-tlm, définissez une CLEANLAB_TLM_API_KEY, et appelez TLM.prompt() pour générer des réponses notées ou get_trustworthiness_score() pour auditer les sorties de votre pile existante.
La plupart des détecteurs d'hallucinations se concentrent sur la fidélité au contexte récupéré. Des métriques comme RAGAS vérifient si une réponse correspond aux documents sources mais manquent les erreurs factuelles lorsque le contexte est mince ou confus. TLM utilise l'estimation de l'incertitude du modèle plutôt que le prompting LLM-en-juge, et Cleanlab publie des benchmarks montrant une précision 3 fois supérieure à RAGAS dans les workflows RAG. Il ne nécessite pas de données d'entraînement étiquetées dans votre domaine, ce qui évite le problème de dérive qui compromet les évaluateurs personnalisés.
Les ingénieurs ML et IA construisant des pipelines RAG, chatbots et systèmes d'agents utilisent TLM pour filtrer les sorties à faible confiance, les orienter vers des humains, ou remplacer par des réponses de secours. L'API couvre les sorties structurées, les appels d'outils, les étiquettes de classification et les conversations multi-tours, pas seulement les complétions de texte simples.
ZenPrompts
Qu'est-ce que ZenPrompts?
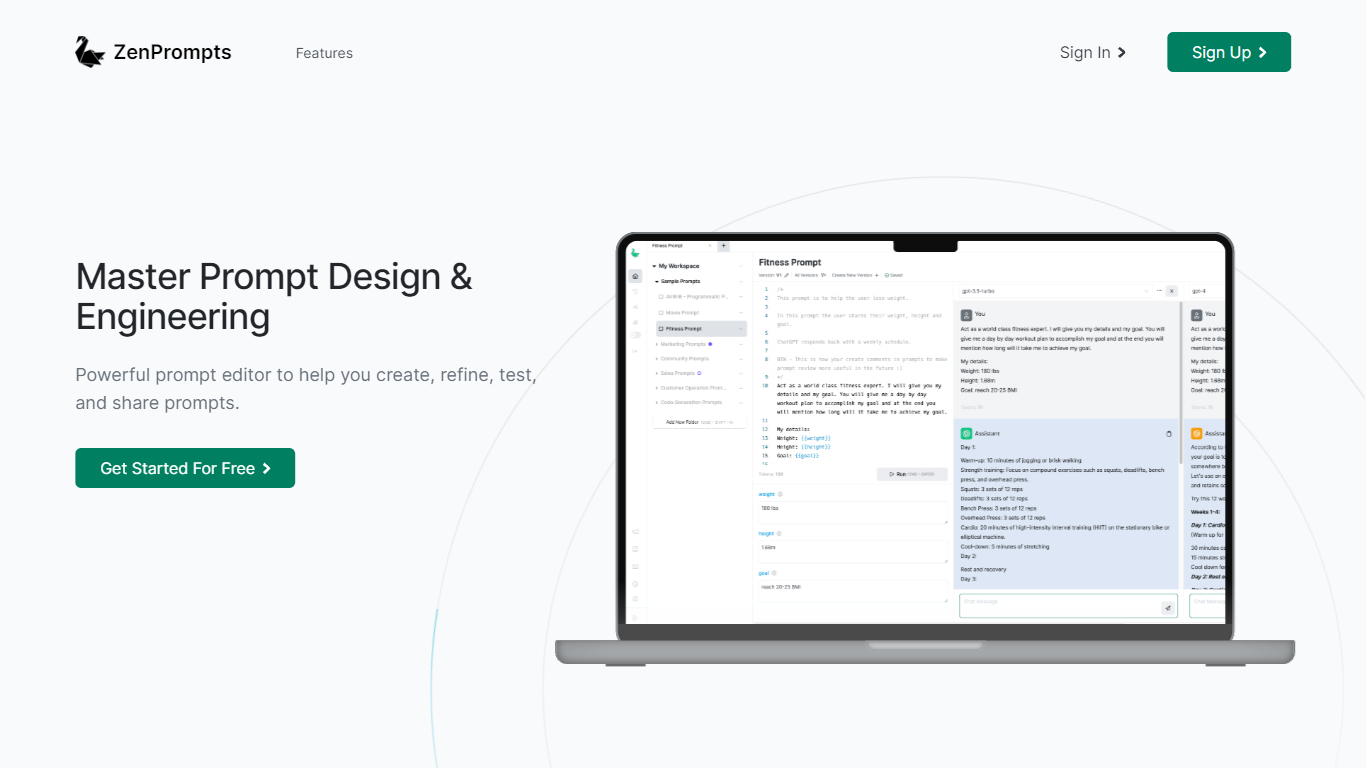
ZenPrompts est une plate-forme de pointe conçue pour permettre aux ingénieurs d'invites de créer, d'affiner, de tester et de partager des invites sophistiquées pour divers modèles OpenAI. Cette plate-forme conviviale dispose d'un puissant éditeur d'invites qui facilite la comparaison des invites entre plusieurs modèles d'IA, garantissant ainsi la sélection de celui le plus approprié en fonction de la qualité, du coût et des performances. Le service, dont l'utilisation est gratuite pendant sa version bêta, fournit aux utilisateurs des outils précieux pour développer et présenter leur portefeuille rapide avec un design minimaliste qui met l'accent sur leur créativité.
Avec ZenPrompts, les utilisateurs peuvent expérimenter des invites sans craindre de perdre leurs travaux antérieurs, partager leurs inventions avec une communauté plus large et adopter la méthode DRY (Don't Repeat Yourself) pour une création efficace d'invites à l'aide de variables dynamiques. De plus, les utilisateurs ont la possibilité de documenter les invites avec des commentaires pour une meilleure organisation et préservation des informations sur le développement. L'objectif de la plateforme est d'améliorer les capacités des ingénieurs prompts et d'afficher leurs compétences à l'ère des grands modèles linguistiques et de l'IA.
TLM Playground Votes positifs
ZenPrompts Votes positifs
TLM Playground Fonctionnalités principales
Chaque réponse retourne un score de fiabilité de 0 à 1 calculé via une estimation de l'incertitude
get_trustworthiness_score() évalue les résultats de n'importe quel LLM sans modifier votre code d'inférence
TLM.prompt() retourne à la fois une réponse et un score en un seul appel API, en utilisant par défaut gpt-4.1-mini comme modèle de base
Les benchmarks rapportent 27% de réponses GPT-4o incorrectes en moins et une détection d'erreurs RAG 3 fois meilleure que RAGAS
Les préréglages de qualité, de faible à élevée, plus TLM Lite, vous permettent d'échanger la latence et le coût contre la profondeur de l'évaluation
TrustworthyRAG Evals évalue la solidité, l'abstention et la suffisance du contexte en plus de la fiabilité
ZenPrompts Fonctionnalités principales
Éditeur d'invites puissant : Un éditeur sophistiqué pour créer efficacement des invites de test et de partage.
Comparaison de modèles : Possibilité de comparer les invites sur plusieurs modèles OpenAI pour garantir la meilleure adéquation à vos besoins.
Présentation élégante du portfolio : Une plateforme minimaliste conçue pour présenter efficacement votre portfolio rapide.
Expérimentation créative : Expérimentez avec des invites sans craindre de perdre les versions précédentes.
Utilisation intelligente des variables dynamiques : Utilisez des variables dynamiques pour rationaliser et rendre les structures d'invite plus réutilisables avec la méthode DRY.
TLM Playground Catégorie
- Model Generation
ZenPrompts Catégorie
- Model Generation
TLM Playground Type de tarification
- Freemium
ZenPrompts Type de tarification
- Freemium