AnyToSpeech vs MusicLM
No confronto entre AnyToSpeech vs MusicLM, qual ferramenta AI Audio Generation sai vitoriosa? Avaliamos avaliações, preços, alternativas, recursos, votos positivos e muito mais.
Quando colocamos AnyToSpeech e MusicLM lado a lado, qual emerge como o vencedor?
Vamos dar uma olhada mais de perto em AnyToSpeech e MusicLM, ambas são ferramentas alimentadas por inteligência artificial na categoria de audio generation, e veja o que os distingue. Não há um vencedor claro em termos de votos positivos, pois ambas as ferramentas receberam o mesmo número. Seu voto importa! Ajude-nos a decidir o vencedor entre os usuários da aitools.fyi votando.
Acha que erramos? Vote e mostre quem manda!
AnyToSpeech

O que é AnyToSpeech?
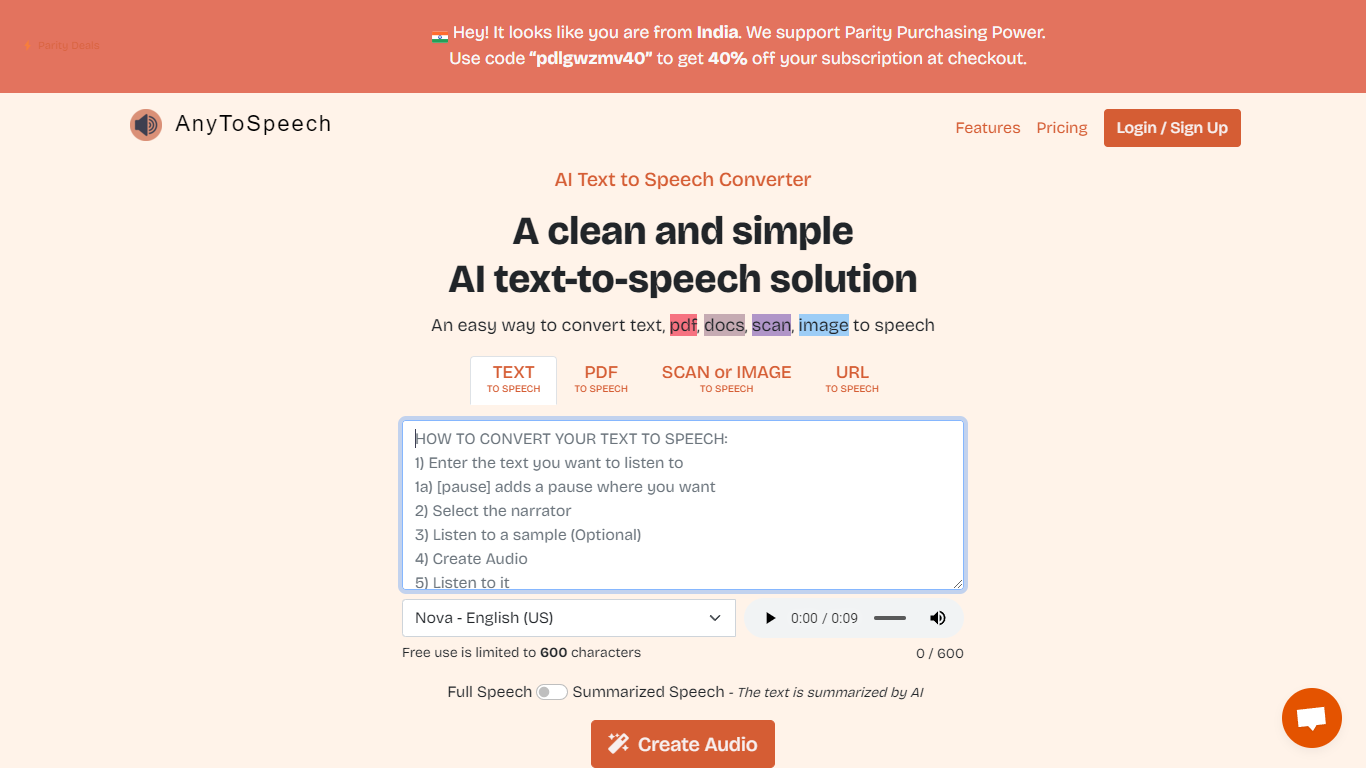
AnyToSpeech é uma plataforma online de conversão de texto em fala que transforma conteúdo escrito em áudio falado. Cole textos simples, envie PDFs, insira URLs ou extraia texto de imagens e receba arquivos MP3 com vozes de som natural.
A plataforma vai muito além do TTS básico. Você pode criar audiobooks de PDFs e documentos, narrar páginas da web, realizar transcrição de fala para texto, clonar sua voz a partir de gravações curtas e gerar episódios de podcast com duas vozes a partir de um resumo de tema ou roteiro. A conversão de PDFs ignora numeração de páginas, notas de rodapé e seções de índice para manter o fluxo de escuta limpo.
AnyToSpeech oferece centenas de opções de vozes em muitos idiomas e sotaques, além de um conjunto grande de ferramentas gratuitas de análise para pronuncição, detecção de sotaque e pontuação de voz. Aplicativos móveis estão disponíveis no Google Play e na Apple App Store.
É ideal para criadores, autores, educadores e qualquer pessoa que prefira ouvir em vez de ler.
MusicLM
O que é MusicLM?
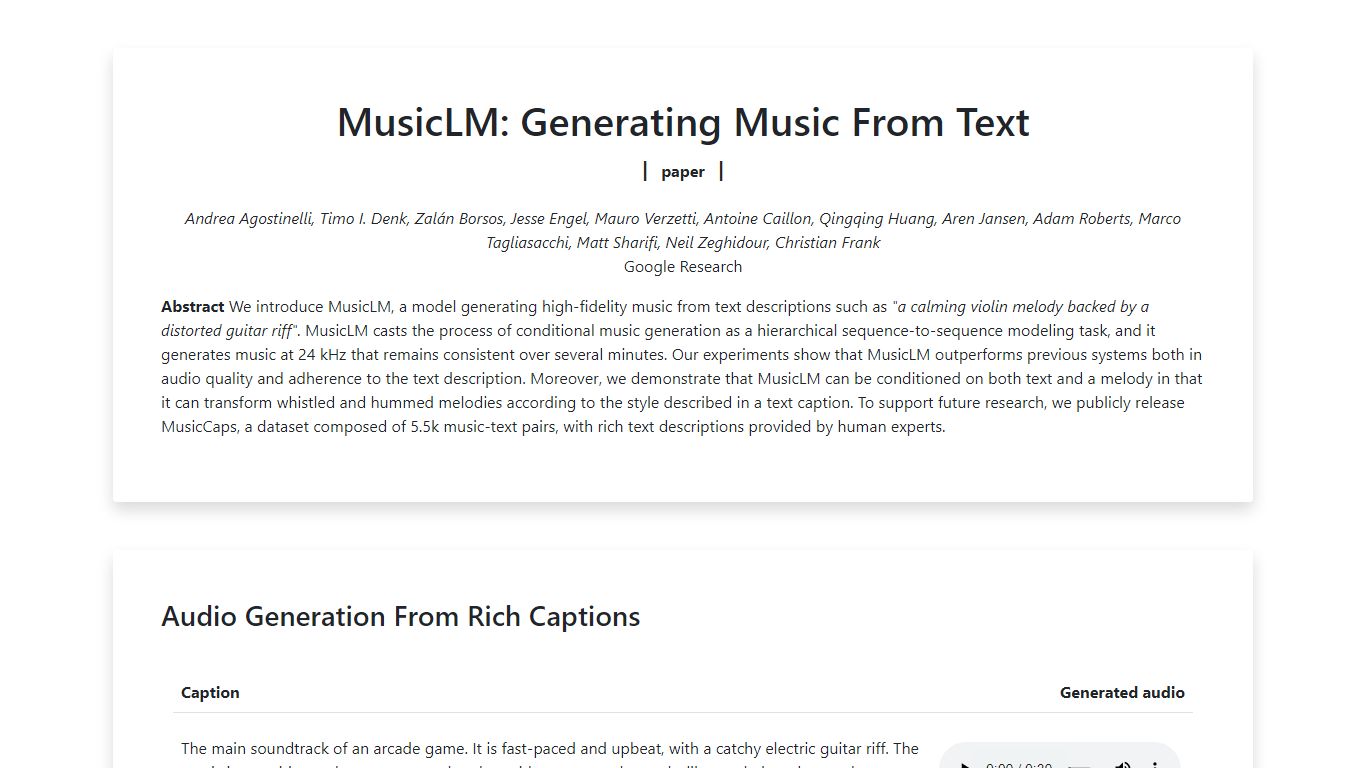
MusicLM é um modelo de geração de áudio do Google Research que cria música a partir de legendas de texto a 24 kHz. A página pública de exemplos hospeda clipes de amostra para comandos como trilhas sonoras de arcade, fusões de reggaeton-EDM e jazz relaxante, além de gerações mais longas no modo história que mudam de estilo ao longo de segmentos temporizados. O Google lançou o conjunto de dados MusicCaps com 5.500 pares de música-texto junto com o artigo.
Diferente de aplicativos para consumidores que oferecem uma única caixa de comando, o MusicLM foi publicado como uma demonstração de pesquisa com amostras pré-geradas, e não como um produto com login. Seu truque principal é o condicionamento conjunto de texto e melodia: você pode cantarolar ou assobiar uma melodia e fazer o modelo regravá-la em um novo gênero descrito em texto. O modo história encadeia múltiplas legendas para que a música evolua ao longo das seções.
O MusicLM é importante como base de pesquisa para os modelos musicais Lyria posteriores do Google, mas esta página é para ouvir exemplos publicados, não para criar novas faixas interativamente. Pesquisadores e músicos o estudam pela consistência em longas durações, condicionamento de pintura para música e resultados de transferência de melodia documentados no artigo de 2023.
AnyToSpeech Votos positivos
MusicLM Votos positivos
AnyToSpeech Recursos principais
Cole texto ou faça upload de PDFs, DOCX e URLs, depois baixe áudios MP3 refinados com taxa de fala ajustável
Clone sua voz a partir de três gravações curtas em cerca de 30 segundos e use-a em todas as ferramentas de conversão
Gere episódios de podcast com dois locutores a partir de um tema ou roteiro, completos com música de introdução e título falado
Faça upload de arquivos de áudio ou vídeo para transcrição que você pode traduzir para mais de 100 idiomas, com 50 minutos gratuitos mensais
Escolha entre centenas de vozes em mais de 24 idiomas de interface, incluindo sotaques regionais específicos ao redor do mundo
MusicLM Recursos principais
Gera música a 24 kHz a partir de legendas de texto enriquecido
Modo história encadeia múltiplos prompts de texto em segmentos temporizados
Condicionamento de texto e melodia transforma melodias assobiadas ou assobiadas em novos estilos
Condicionamento de legenda de pintura combina descrições de obras de arte com áudio gerado
Exemplos de geração longa cobrem techno melódico, swing e jazz relaxante
O conjunto de dados MusicCaps inclui 5.500 pares de música e texto escritos por especialistas
AnyToSpeech Categoria
- Audio Generation
MusicLM Categoria
- Audio Generation
AnyToSpeech Tipo de tarifação
- Freemium
MusicLM Tipo de tarifação
- Free