ChatTTS vs VALL-E
Na batalha entre ChatTTS vs VALL-E, qual ferramenta AI Audio Generation sai por cima? Comparamos avaliações, preços, alternativas, votos positivos, recursos e muito mais.
Entre ChatTTS e VALL-E, qual é superior?
Ao comparar ChatTTS com VALL-E, ambas ferramentas são alimentadas por inteligência artificial na categoria de audio generation, Os usuários deixaram sua preferência clara, ChatTTS lidera em votos positivos. ChatTTS recebeu 6 votos positivos, e VALL-E recebeu 5 votos positivos.
Acha que erramos? Vote e mostre quem manda!
ChatTTS

O que é ChatTTS?
ChatTTS é um modelo de texto-para-fala de código aberto, criado para diálogos. A equipe 2Noise treinou-o com mais de 100.000 horas de fala em chinês e inglês, para que soe natural em conversas trocadas, e não apenas em narração roteirizada.
O que o diferencia é o controle de prosódia em um nível granular. O modelo pode acrescentar risadas, pausas e interjeições, além de lidar com múltiplos falantes em uma única sessão. Isso o torna adequado para assistentes com LLM, áudio conversacional e multimídia com diálogos intensos.
Desenvolvedores podem instalá-lo via pip ou clonando o repositório no GitHub. A versão de código aberto disponível no Hugging Face é um modelo base de 40.000 horas, sob licença AGPLv3+. A equipe o posiciona para usos em pesquisa e diálogo, com contato em [email protected] para perguntas sobre o roteiro de desenvolvimento.
VALL-E
O que é VALL-E?
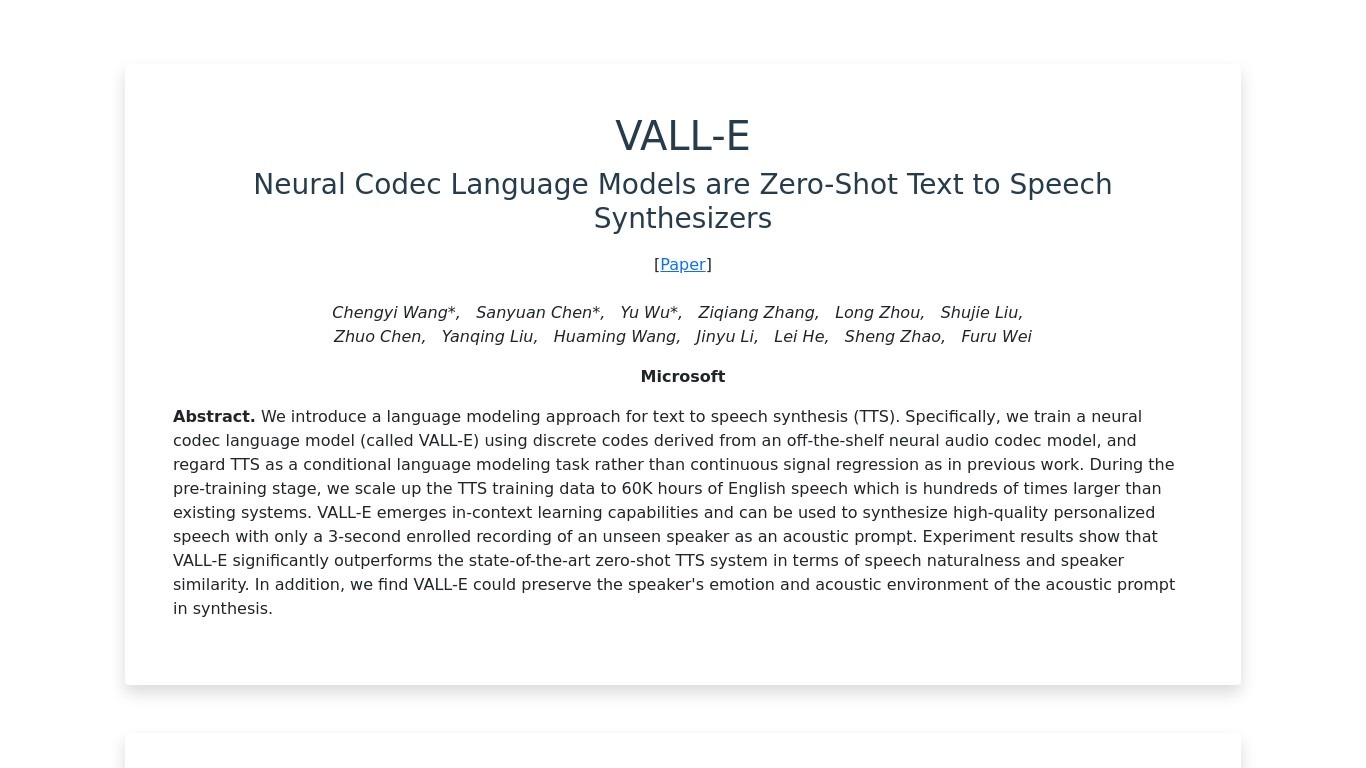
VALL-E é um modelo de texto para fala da Microsoft Research que clona a voz de um locutor a partir de um curto clipe de áudio e gera nova fala a partir do texto. Pertence à categoria de geração de áudio porque sintetiza fala natural em vez de editar gravações existentes. A página do projeto hospeda áudios de exemplo para o modelo original VALL-E e variantes posteriores da mesma família de pesquisa.
A maioria dos sistemas TTS regredem formas de onda contínuas ou mel-espectrogramas diretamente. VALL-E, em vez disso, trata a fala como uma tarefa de modelagem condicional de linguagem sobre códigos discretos de um codec neural de áudio. A Microsoft o treinou com cerca de 60.000 horas de fala em inglês, muito maior que os conjuntos de dados típicos de TTS. Uma gravação de 3 segundos de um locutor não visto é suficiente para conduzir a síntese zero-shot, e o modelo pode manter a emoção e o tom ambiente presentes nesse prompt.
A família VALL-E cresceu além do primeiro artigo. VALL-E X lida com TTS zero-shot cross-lingual, VALL-E R adiciona alinhamento monotônico de fonemas para uma geração de fala mais estável, e VALL-E 2 combina amostragem consciente de repetição com modelagem de código agrupado para alcançar paridade humana nos benchmarks LibriSpeech e VCTK. Linhas relacionadas como MELLE, FELLE e PALLE exploram tokens mel contínuos e decodificação híbrida autoregressiva mais paralela.
Pesquisadores, engenheiros de fala e ouvintes curiosos usam VALL-E para ouvir o que modelos de linguagem de codec em larga escala podem fazer antes de construir seus próprios pipelines. As amostras públicas são demos de pesquisa, não uma API hospedada que você pode integrar a um produto sem licenciamento e revisão ética separada.
ChatTTS Votos positivos
VALL-E Votos positivos
ChatTTS Recursos principais
Modela risadas, pausas e interjeições em fala sintetizada
Executa diálogo multi-orador a partir de uma única chamada de inferência
Treinado com mais de 100.000 horas de áudio em chinês e inglês
Transmite saída de áudio para reprodução em tempo real
Instale via pip ou baixe os pesos do Hugging Face
VALL-E Recursos principais
Clona um alto-falante não visto a partir de um prompt de áudio de 3 segundos registrado
Pré-treinado em cerca de 60.000 horas de dados de fala em inglês
VALL-E 2 relata paridade humana nos benchmarks zero-shot LibriSpeech e VCTK
Preserva a emoção do alto-falante e o ambiente acústico do trecho do prompt
VALL-E X estende a síntese zero-shot para cenários cross-lingua
As páginas de amostra cobrem sete linhas de modelos incluindo MELLE, FELLE e PALLE
ChatTTS Categoria
- Audio Generation
VALL-E Categoria
- Audio Generation
ChatTTS Tipo de tarifação
- Free
VALL-E Tipo de tarifação
- Free