FinetuneFast vs LiteLLM
Na batalha entre FinetuneFast vs LiteLLM, qual ferramenta AI Large Language Model (LLM) sai por cima? Comparamos avaliações, preços, alternativas, votos positivos, recursos e muito mais.
Qual é melhor? FinetuneFast ou LiteLLM?
Ao comparar FinetuneFast com LiteLLM, ambas ferramentas são alimentadas por inteligência artificial na categoria de large language model (llm), FinetuneFast é o claro vencedor em termos de votos positivos. FinetuneFast foi votado positivamente 8 vezes pelos usuários da aitools.fyi, e LiteLLM foi votado positivamente 6 vezes.
Não é a sua praia? Vote em sua ferramenta preferida e mexa as coisas!
FinetuneFast
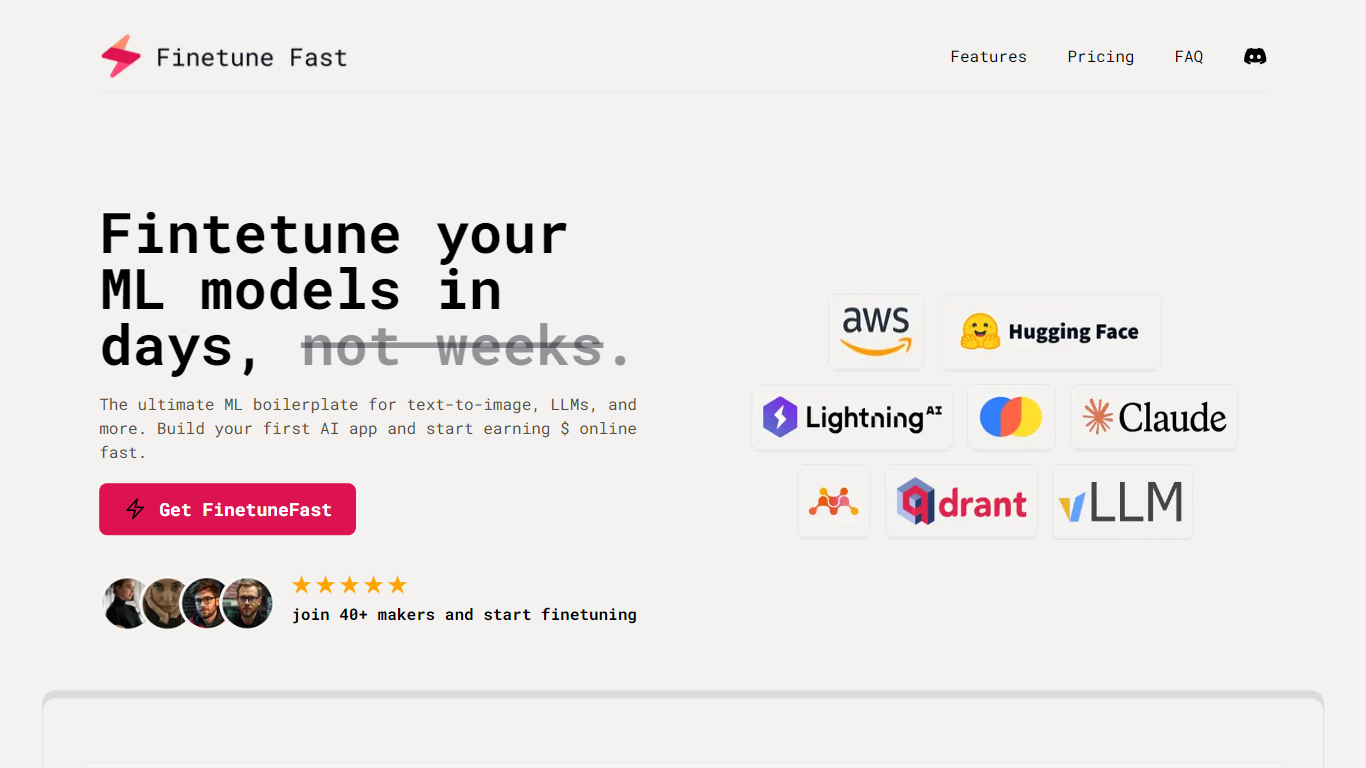

O que é FinetuneFast?
FinetuneFast é um kit de boilerplate pago para ajuste fino e implantação de modelos de aprendizado de máquina. Ele inclui scripts de treinamento pré-configurados, pipelines de carregamento de dados, otimização de hiperparâmetros e modelos de implantação, permitindo que os desenvolvedores passem do setup à produção mais rapidamente do que construindo tudo do zero.
O pacote cobre tarefas de texto para imagem, grandes modelos de linguagem, aplicações RAG e fluxos de trabalho relacionados. Os exemplos incluídos fazem referência a provedores como AWS Bedrock, Mistral AI e OpenAI, juntamente com modelos para Flux-Schnell (texto para imagem), Fish-Speech (texto para fala) e geração com recuperação aumentada.
Após a compra, os compradores recebem acesso aos materiais do repositório no GitHub com documentação. O plano All In inclui acesso à comunidade no Discord e atualizações vitalícias. O fundador Patrick desenvolveu o produto com base em experiência prática em engenharia de ML, incluindo trabalho em treinamento de modelos, APIs de inferência e infraestrutura escalável.
LiteLLM
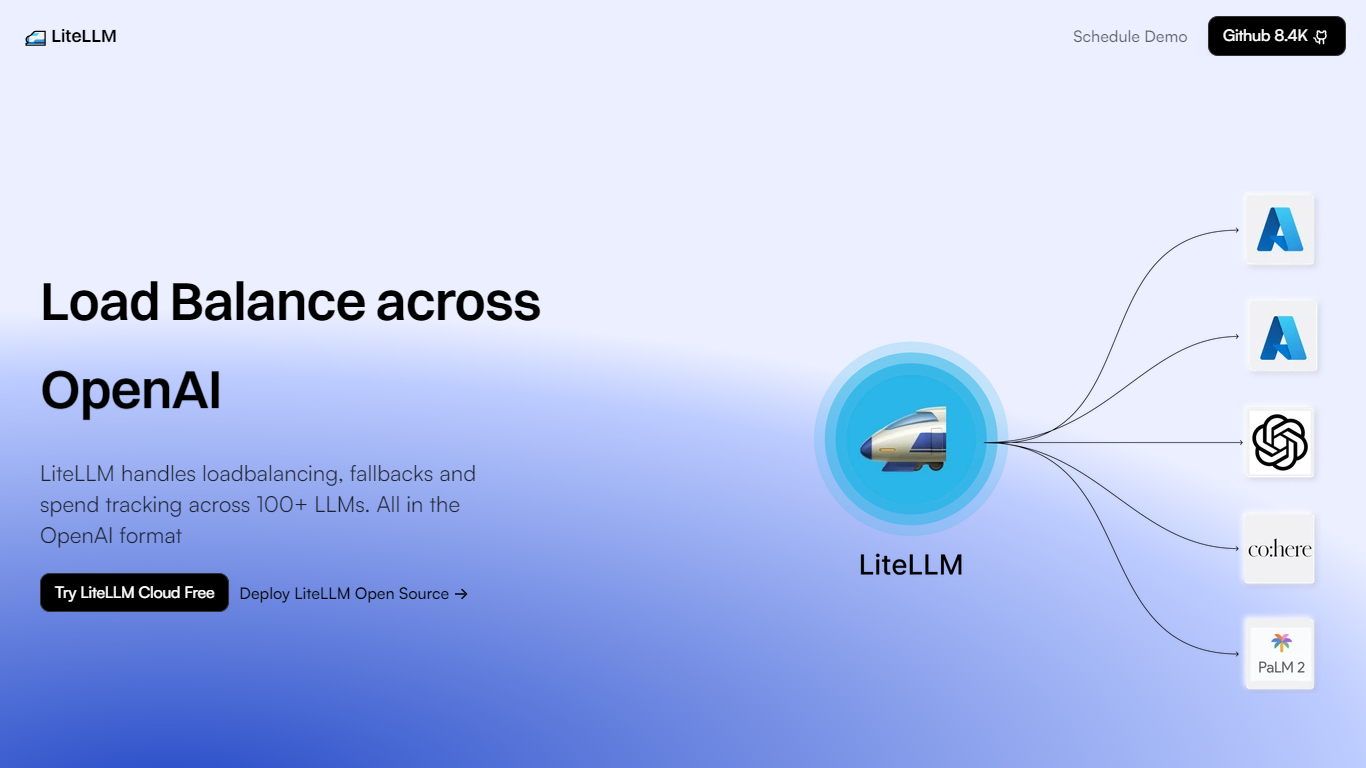
O que é LiteLLM?
LiteLLM é um gateway de IA auto-hospedado e proxy LLM que fica entre seus aplicativos e os provedores de modelos. Você direciona os clientes para um endpoint compatível com OpenAI, e o gateway gerencia o roteamento, registro e controles de gastos em mais de 140 backends. Equipes da Netflix, NVIDIA e Okta o utilizam para padronizar o acesso a modelos sem precisar reconstruir cada serviço quando um provedor muda.
Enquanto proxies hospedados cobram por token e mantêm as chaves na nuvem deles, o LiteLLM roda na sua VPC ou em um cluster isolado sob licença MIT. Orçamentos e limites de RPM/TPM são bloqueios rígidos, não alertas, então uma chave vazada ou trabalho descontrolado não pode continuar gastando após atingir o limite.
Equipes de plataforma e infraestrutura de ML recorrem a ele quando precisam de uma única porta de entrada para humanos, agentes e trabalhos em lote. O mesmo gateway cobre chamadas LLM, servidores MCP e fluxos de trabalho de agentes, com SSO empresarial, logs de auditoria e SLAs quando a implantação é em toda a empresa.
FinetuneFast Votos positivos
LiteLLM Votos positivos
FinetuneFast Recursos principais
Scripts de treinamento pré-configurados com suporte multi-GPU e opções de fine-tuning sem código
Pipelines eficientes de carregamento de dados para preparar e organizar conjuntos de dados de treinamento
Ferramentas de otimização de hiperparâmetros para ajustar o desempenho do modelo
Deploy com um clique com infraestrutura de autoescalonamento e endpoints de API gerados
Modelos de inferência prontos para produção, exemplos RAG e templates iniciais para SaaS de IA
Cobertura de modelos inclui integrações Flux-Schnell, Mistral, OpenAI, Fish-Speech TTS e workflows RAG
LiteLLM Recursos principais
Uma API compatível com OpenAI direciona solicitações para mais de 140 provedores e 1.892 modelos
Orçamentos rígidos mais limites de RPM e TPM por chave, equipe e organização interrompem o tráfego no limite
Gateway auto-hospedado licenciado pelo MIT com mais de 240M de pulls no Docker e suporte a implantação isolada
Rust AI Gateway adiciona 0,66 ms de latência p99 em mais de 2.800 solicitações por segundo em benchmarks publicados
Barreiras integradas cobrem mascaramento de PII e verificações de injeção de prompt via Presidio e Lakera
Chaves virtuais, rastreamento de gastos e métricas Prometheus são enviados na camada de código aberto gratuita
FinetuneFast Categoria
- Large Language Model (LLM)
LiteLLM Categoria
- Large Language Model (LLM)
FinetuneFast Tipo de tarifação
- Paid
LiteLLM Tipo de tarifação
- Freemium