FinetuneFast vs UniLM
Mergulhe na comparação entre FinetuneFast vs UniLM e descubra qual ferramenta AI Large Language Model (LLM) se destaca. Examinamos alternativas, votos positivos, recursos, avaliações, preços e muito mais.
Em uma comparação entre FinetuneFast e UniLM, qual sai por cima?
Ao comparar FinetuneFast e UniLM, duas ferramentas excepcionais da categoria de large language model (llm) alimentadas por inteligência artificial, e colocá-las lado a lado, várias semelhanças e diferenças-chave se destacam. FinetuneFast é o claro vencedor em termos de votos positivos. FinetuneFast atraiu 8 votos positivos dos usuários da aitools.fyi, e UniLM atraiu 6 votos positivos.
Quer mudar o jogo? Vote em sua ferramenta favorita e mude a história!
FinetuneFast
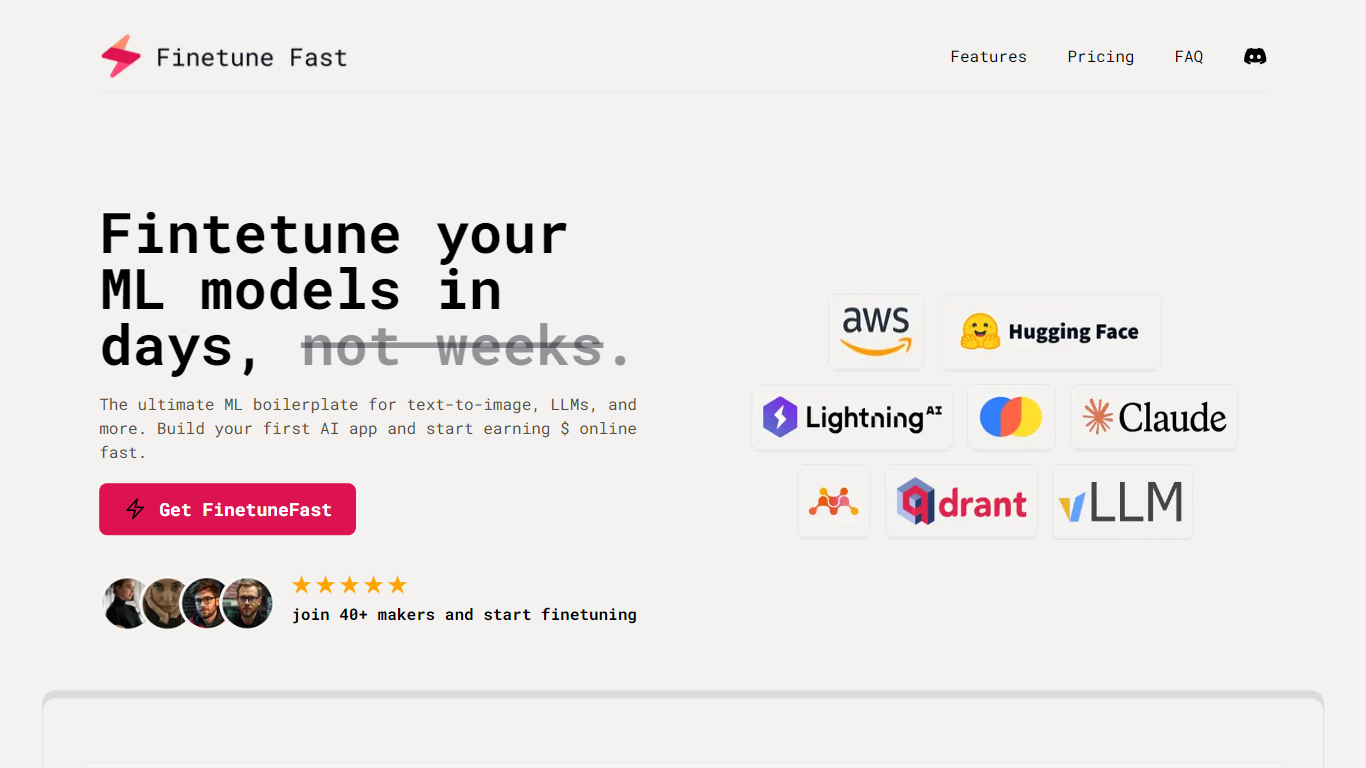

O que é FinetuneFast?
FinetuneFast é um kit de boilerplate pago para ajuste fino e implantação de modelos de aprendizado de máquina. Ele inclui scripts de treinamento pré-configurados, pipelines de carregamento de dados, otimização de hiperparâmetros e modelos de implantação, permitindo que os desenvolvedores passem do setup à produção mais rapidamente do que construindo tudo do zero.
O pacote cobre tarefas de texto para imagem, grandes modelos de linguagem, aplicações RAG e fluxos de trabalho relacionados. Os exemplos incluídos fazem referência a provedores como AWS Bedrock, Mistral AI e OpenAI, juntamente com modelos para Flux-Schnell (texto para imagem), Fish-Speech (texto para fala) e geração com recuperação aumentada.
Após a compra, os compradores recebem acesso aos materiais do repositório no GitHub com documentação. O plano All In inclui acesso à comunidade no Discord e atualizações vitalícias. O fundador Patrick desenvolveu o produto com base em experiência prática em engenharia de ML, incluindo trabalho em treinamento de modelos, APIs de inferência e infraestrutura escalável.
UniLM
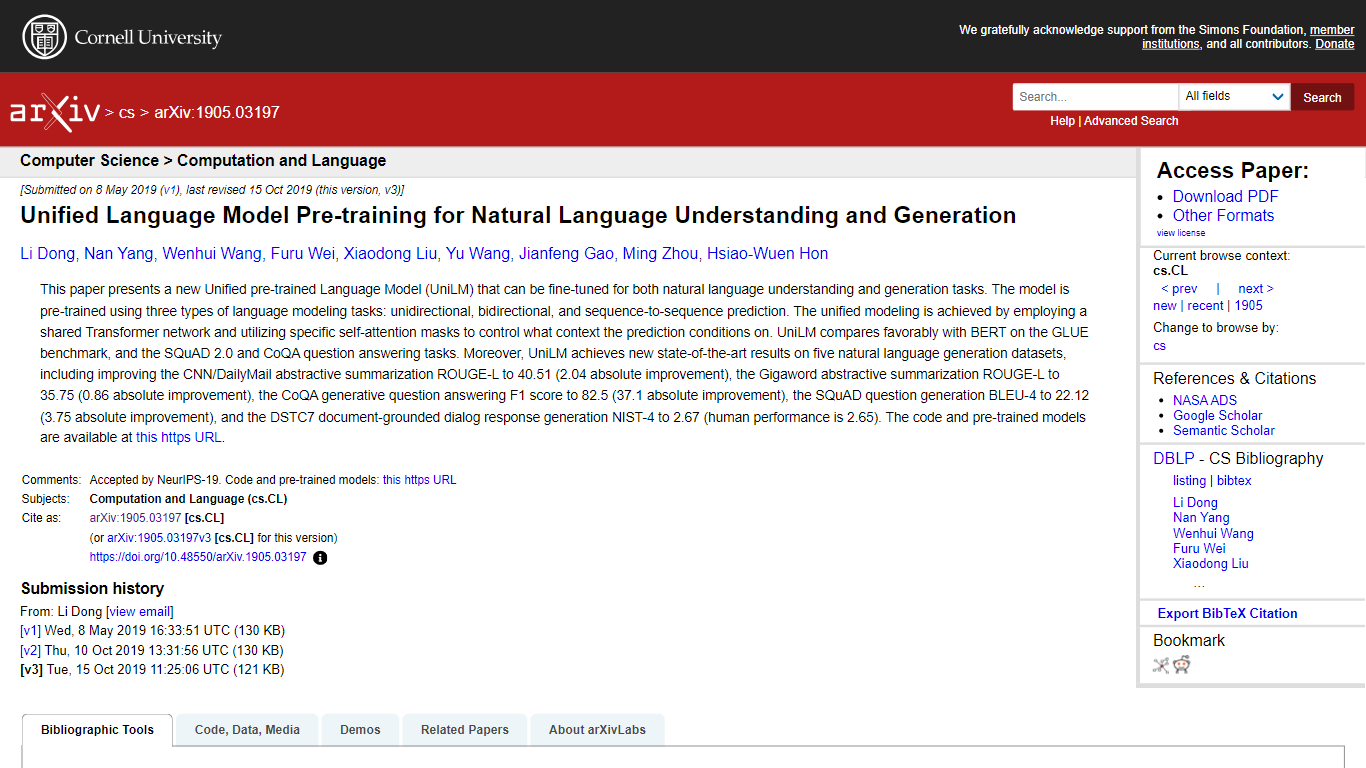
O que é UniLM?
UniLM é um modelo de linguagem pré-treinado da Microsoft Research que lida tanto com compreensão de linguagem natural quanto com geração de texto a partir de um Transformer compartilhado. Você ajusta finamente uma única etapa de verificação para tarefas de leitura, como resposta a perguntas, e tarefas de escrita, como sumarização ou diálogo, sem precisar manter modelos separados apenas para codificador e apenas para decodificador. Código e pesos pré-treinados são disponibilizados através do repositório GitHub microsoft/unilm sob uma licença MIT.
Modelos no estilo BERT são excelentes para leitura, mas precisam de uma pilha de decodificador separada para geração. UniLM treina um Transformer com três modos de máscara de atenção: unidirecional, bidirecional e sequência a sequência. Esse design permite que os mesmos pesos concorram com o BERT no GLUE e no SQuAD, ao mesmo tempo que estabelecem benchmarks de sumarização e geração de perguntas em 2019, uma divisão que a maioria dos contemporâneos tratava como dois problemas.
Pesquisadores de ML e engenheiros de NLP usam UniLM quando desejam benchmarks publicados, scripts de treinamento e arquivos de verificação para compreensão e geração em um único código. O repositório agora abrange versões posteriores, como o UniLMv2 (Pseudo-Masked Language Model, ICML 2020), mas a versão 1 permanece como referência para a abordagem de máscara unificada original, descrita no artigo do NeurIPS 2019.
FinetuneFast Votos positivos
UniLM Votos positivos
FinetuneFast Recursos principais
Scripts de treinamento pré-configurados com suporte multi-GPU e opções de fine-tuning sem código
Pipelines eficientes de carregamento de dados para preparar e organizar conjuntos de dados de treinamento
Ferramentas de otimização de hiperparâmetros para ajustar o desempenho do modelo
Deploy com um clique com infraestrutura de autoescalonamento e endpoints de API gerados
Modelos de inferência prontos para produção, exemplos RAG e templates iniciais para SaaS de IA
Cobertura de modelos inclui integrações Flux-Schnell, Mistral, OpenAI, Fish-Speech TTS e workflows RAG
UniLM Recursos principais
Três objetivos de pré-treinamento (unidirecional, bidirecional, sequência-para-sequência) compartilham uma única arquitetura Transformer
Resumo abstrativo CNN/DailyMail ROUGE-L de 40,51, um ganho de 2,04 pontos em relação ao trabalho anterior
Pontuação F1 de 82,5 em pergunta e resposta generativa CoQA no benchmark publicado
Geração de perguntas SQuAD BLEU-4 de 22,12 com decodificação beam search
Checkpoints pré-treinados e scripts de treinamento PyTorch no repositório microsoft/unilm (22,2 mil estrelas no GitHub)
Licença MIT com os códigos UniLM v1 e UniLMv2 no mesmo repositório open-source
FinetuneFast Categoria
- Large Language Model (LLM)
UniLM Categoria
- Large Language Model (LLM)
FinetuneFast Tipo de tarifação
- Paid
UniLM Tipo de tarifação
- Free