Moshi AI vs AnyToSpeech
No confronto entre Moshi AI vs AnyToSpeech, qual ferramenta AI Audio Generation sai vitoriosa? Avaliamos avaliações, preços, alternativas, recursos, votos positivos e muito mais.
Quando colocamos Moshi AI e AnyToSpeech lado a lado, qual emerge como o vencedor?
Vamos dar uma olhada mais de perto em Moshi AI e AnyToSpeech, ambas são ferramentas alimentadas por inteligência artificial na categoria de audio generation, e veja o que os distingue. Nenhuma ferramenta assume a liderança, pois ambas têm o mesmo número de votos positivos. O poder está em suas mãos! Vote e participe da decisão do vencedor.
Não é a sua praia? Vote em sua ferramenta preferida e mexa as coisas!
Moshi AI

O que é Moshi AI?
Moshi AI é um modelo conversacional nativo de fala da Kyutai, um laboratório de pesquisa em ciência aberta com sede em Paris. Em vez de encadear reconhecimento de fala, geração de texto e síntese de fala, o Moshi processa áudio diretamente e mantém conversas de voz full-duplex com mínima latência.
Seu design multi-stream executa canais separados para o usuário, a saída falada do Moshi e um fluxo de texto de Monólogo Interno que melhora a coerência. Essa configuração permite que o Moshi ouça e fale ao mesmo tempo, lidando com sobreposições, interrupções e respostas de acompanhamento como uma conversa real, ao invés de turnos rígidos de fala.
O Moshi é construído sobre o Helium, um modelo de linguagem de 7B, e o Mimi, o codec de áudio neural da Kyutai. Pesos e código de inferência são disponibilizados para PyTorch, Rust e MLX, e você pode experimentá-lo no navegador em moshi-chat.kyutai.org. Pesquisadores, desenvolvedores de voice AI e qualquer pessoa que esteja construindo interfaces de fala em tempo real encontrarão aqui o máximo de valor.
AnyToSpeech
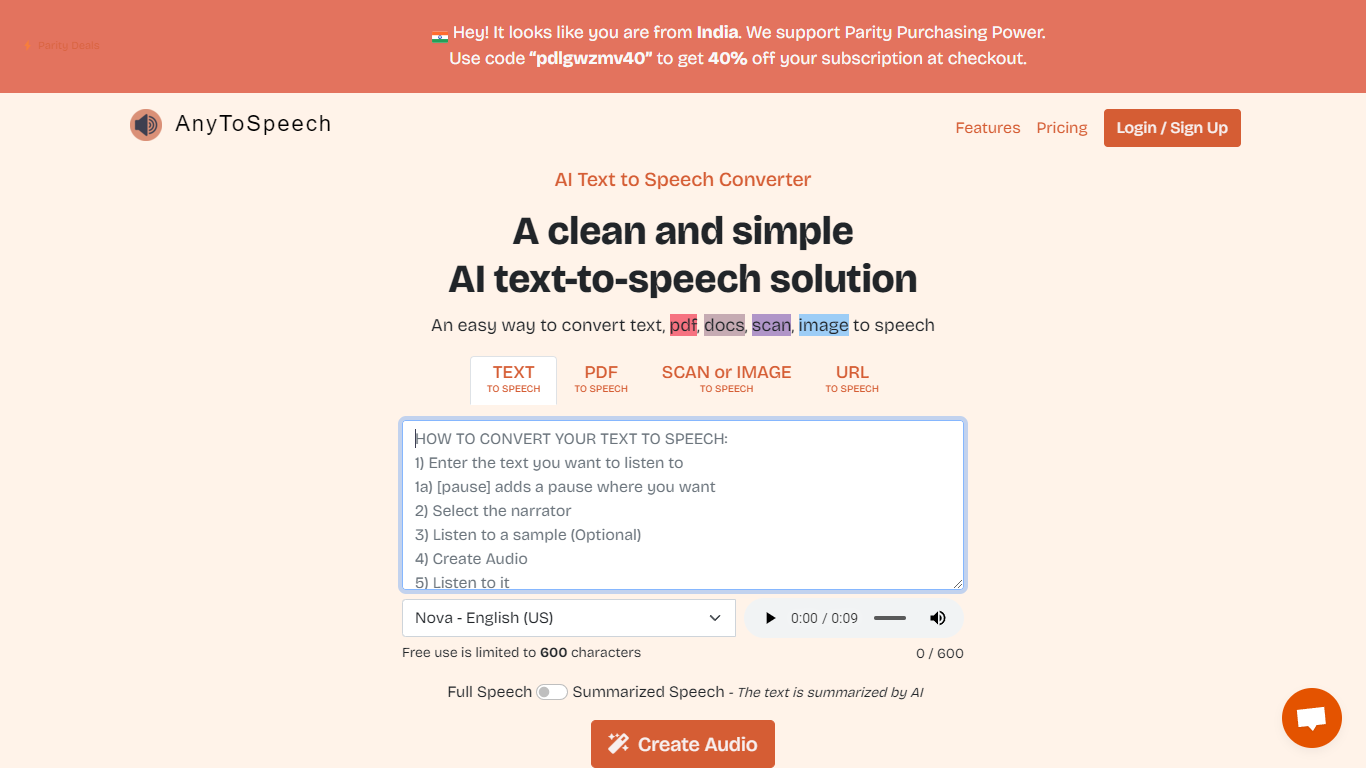
O que é AnyToSpeech?
AnyToSpeech é uma plataforma online de conversão de texto em fala que transforma conteúdo escrito em áudio falado. Cole textos simples, envie PDFs, insira URLs ou extraia texto de imagens e receba arquivos MP3 com vozes de som natural.
A plataforma vai muito além do TTS básico. Você pode criar audiobooks de PDFs e documentos, narrar páginas da web, realizar transcrição de fala para texto, clonar sua voz a partir de gravações curtas e gerar episódios de podcast com duas vozes a partir de um resumo de tema ou roteiro. A conversão de PDFs ignora numeração de páginas, notas de rodapé e seções de índice para manter o fluxo de escuta limpo.
AnyToSpeech oferece centenas de opções de vozes em muitos idiomas e sotaques, além de um conjunto grande de ferramentas gratuitas de análise para pronuncição, detecção de sotaque e pontuação de voz. Aplicativos móveis estão disponíveis no Google Play e na Apple App Store.
É ideal para criadores, autores, educadores e qualquer pessoa que prefira ouvir em vez de ler.
Moshi AI Votos positivos
AnyToSpeech Votos positivos
Moshi AI Recursos principais
Processa a fala diretamente sem um pipeline de texto intermediário
Escuta e fala simultaneamente com suporte a sobreposição e interrupção
O fluxo de texto Inner Monologue melhora a qualidade da fala e o raciocínio
Executa em tempo real em uma GPU L4 ou MacBook Pro M3 via o codec Mimi
Pesos abertos no Hugging Face com código de inferência PyTorch, Rust e MLX
AnyToSpeech Recursos principais
Cole texto ou faça upload de PDFs, DOCX e URLs, depois baixe áudios MP3 refinados com taxa de fala ajustável
Clone sua voz a partir de três gravações curtas em cerca de 30 segundos e use-a em todas as ferramentas de conversão
Gere episódios de podcast com dois locutores a partir de um tema ou roteiro, completos com música de introdução e título falado
Faça upload de arquivos de áudio ou vídeo para transcrição que você pode traduzir para mais de 100 idiomas, com 50 minutos gratuitos mensais
Escolha entre centenas de vozes em mais de 24 idiomas de interface, incluindo sotaques regionais específicos ao redor do mundo
Moshi AI Categoria
- Audio Generation
AnyToSpeech Categoria
- Audio Generation
Moshi AI Tipo de tarifação
- Free
AnyToSpeech Tipo de tarifação
- Freemium