Moshi AI vs VALL-E
Explore o confronto entre Moshi AI vs VALL-E e descubra qual ferramenta AI Audio Generation vence. Analisamos votos positivos, recursos, avaliações, preços, alternativas e muito mais.
Ao comparar Moshi AI e VALL-E, qual se destaca?
Ao contrastar Moshi AI com VALL-E, ambas são ferramentas excepcionais operadas por inteligência artificial na categoria de audio generation, e ao colocá-las lado a lado, podemos notar várias semelhanças e divergências cruciais. Com mais votos positivos, Moshi AI é a escolha preferida. Moshi AI foi votado positivamente 6 vezes pelos usuários da aitools.fyi, e VALL-E foi votado positivamente 5 vezes.
Não concorda com o resultado? Vote em sua ferramenta favorita e ajude-a a vencer!
Moshi AI

O que é Moshi AI?
Moshi AI é um modelo conversacional nativo de fala da Kyutai, um laboratório de pesquisa em ciência aberta com sede em Paris. Em vez de encadear reconhecimento de fala, geração de texto e síntese de fala, o Moshi processa áudio diretamente e mantém conversas de voz full-duplex com mínima latência.
Seu design multi-stream executa canais separados para o usuário, a saída falada do Moshi e um fluxo de texto de Monólogo Interno que melhora a coerência. Essa configuração permite que o Moshi ouça e fale ao mesmo tempo, lidando com sobreposições, interrupções e respostas de acompanhamento como uma conversa real, ao invés de turnos rígidos de fala.
O Moshi é construído sobre o Helium, um modelo de linguagem de 7B, e o Mimi, o codec de áudio neural da Kyutai. Pesos e código de inferência são disponibilizados para PyTorch, Rust e MLX, e você pode experimentá-lo no navegador em moshi-chat.kyutai.org. Pesquisadores, desenvolvedores de voice AI e qualquer pessoa que esteja construindo interfaces de fala em tempo real encontrarão aqui o máximo de valor.
VALL-E
O que é VALL-E?
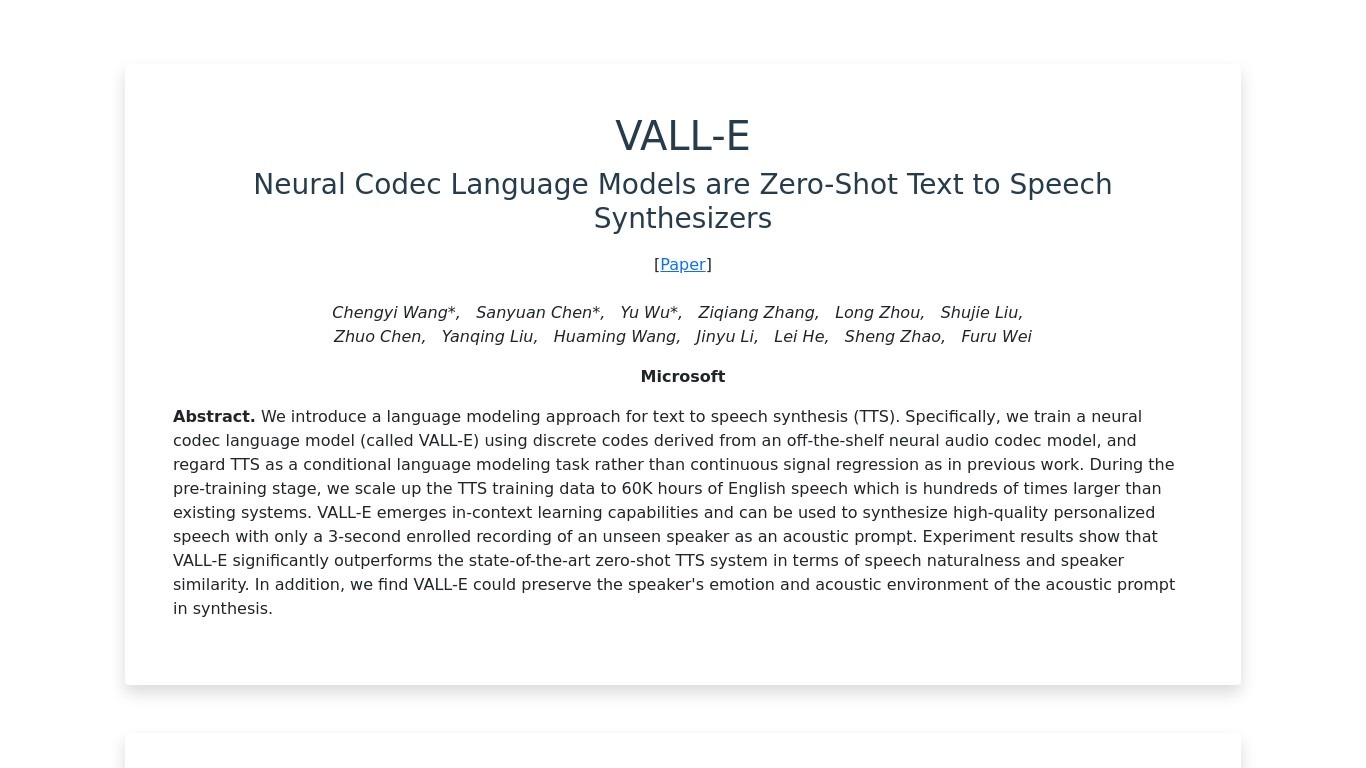
VALL-E é um modelo de texto para fala da Microsoft Research que clona a voz de um locutor a partir de um curto clipe de áudio e gera nova fala a partir do texto. Pertence à categoria de geração de áudio porque sintetiza fala natural em vez de editar gravações existentes. A página do projeto hospeda áudios de exemplo para o modelo original VALL-E e variantes posteriores da mesma família de pesquisa.
A maioria dos sistemas TTS regredem formas de onda contínuas ou mel-espectrogramas diretamente. VALL-E, em vez disso, trata a fala como uma tarefa de modelagem condicional de linguagem sobre códigos discretos de um codec neural de áudio. A Microsoft o treinou com cerca de 60.000 horas de fala em inglês, muito maior que os conjuntos de dados típicos de TTS. Uma gravação de 3 segundos de um locutor não visto é suficiente para conduzir a síntese zero-shot, e o modelo pode manter a emoção e o tom ambiente presentes nesse prompt.
A família VALL-E cresceu além do primeiro artigo. VALL-E X lida com TTS zero-shot cross-lingual, VALL-E R adiciona alinhamento monotônico de fonemas para uma geração de fala mais estável, e VALL-E 2 combina amostragem consciente de repetição com modelagem de código agrupado para alcançar paridade humana nos benchmarks LibriSpeech e VCTK. Linhas relacionadas como MELLE, FELLE e PALLE exploram tokens mel contínuos e decodificação híbrida autoregressiva mais paralela.
Pesquisadores, engenheiros de fala e ouvintes curiosos usam VALL-E para ouvir o que modelos de linguagem de codec em larga escala podem fazer antes de construir seus próprios pipelines. As amostras públicas são demos de pesquisa, não uma API hospedada que você pode integrar a um produto sem licenciamento e revisão ética separada.
Moshi AI Votos positivos
VALL-E Votos positivos
Moshi AI Recursos principais
Processa a fala diretamente sem um pipeline de texto intermediário
Escuta e fala simultaneamente com suporte a sobreposição e interrupção
O fluxo de texto Inner Monologue melhora a qualidade da fala e o raciocínio
Executa em tempo real em uma GPU L4 ou MacBook Pro M3 via o codec Mimi
Pesos abertos no Hugging Face com código de inferência PyTorch, Rust e MLX
VALL-E Recursos principais
Clona um alto-falante não visto a partir de um prompt de áudio de 3 segundos registrado
Pré-treinado em cerca de 60.000 horas de dados de fala em inglês
VALL-E 2 relata paridade humana nos benchmarks zero-shot LibriSpeech e VCTK
Preserva a emoção do alto-falante e o ambiente acústico do trecho do prompt
VALL-E X estende a síntese zero-shot para cenários cross-lingua
As páginas de amostra cobrem sete linhas de modelos incluindo MELLE, FELLE e PALLE
Moshi AI Categoria
- Audio Generation
VALL-E Categoria
- Audio Generation
Moshi AI Tipo de tarifação
- Free
VALL-E Tipo de tarifação
- Free