SpeechGPT vs VALL-E
Compare SpeechGPT vs VALL-E e veja qual ferramenta AI Audio Generation é melhor quando comparamos recursos, avaliações, preços, alternativas, votos positivos, etc.
Qual é melhor? SpeechGPT ou VALL-E?
Quando comparamos SpeechGPT com VALL-E, ambas ferramentas são alimentadas por inteligência artificial na categoria de audio generation, O número de votos positivos favorece SpeechGPT, tornando-o o claro vencedor. O número de votos positivos para SpeechGPT é de 6, e para VALL-E é de 5.
O resultado faz você dizer "hmm"? Vote e transforme essa carranca em um sorriso!
SpeechGPT

O que é SpeechGPT?
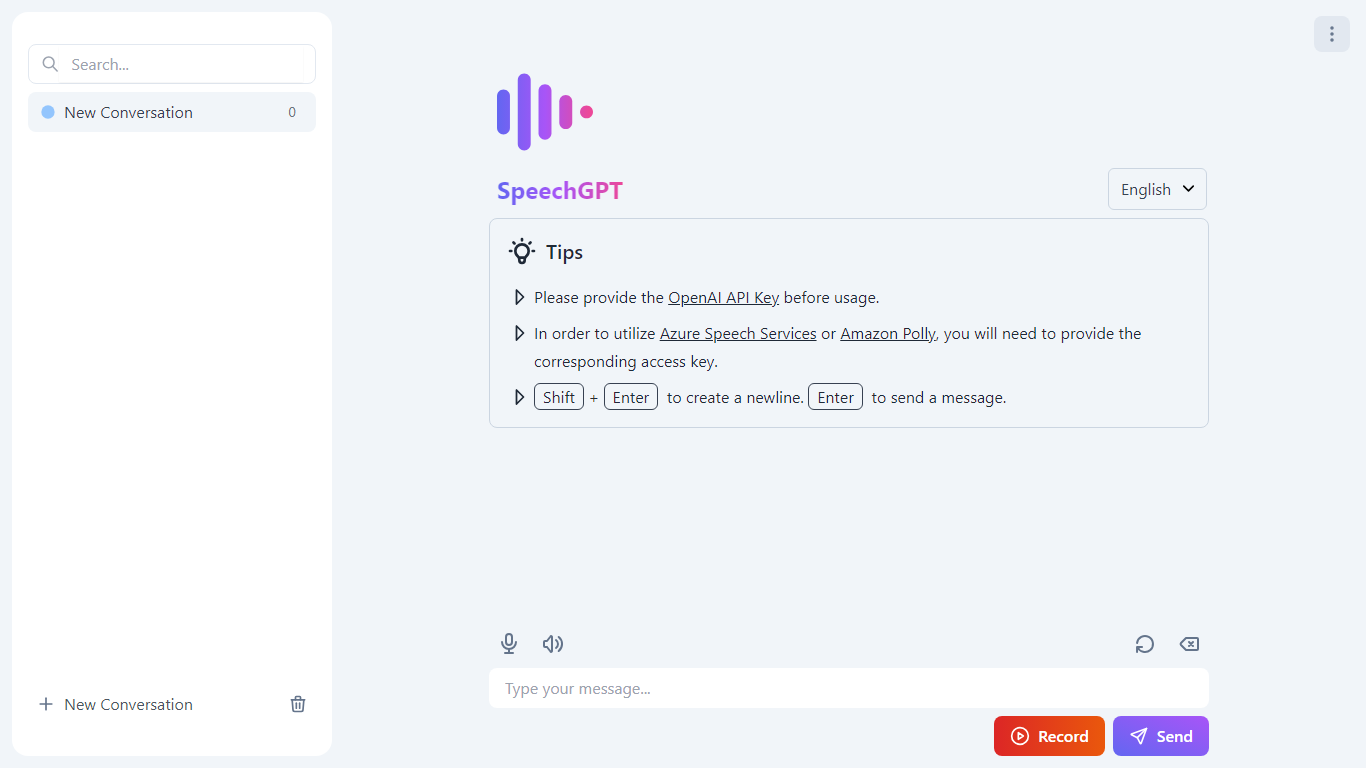
SpeechGPT permite que você mantenha conversas por voz no navegador usando sua própria chave de API OpenAI. Você digita ou grava mensagens, envia-as por meio de uma interface de chat e ouve respostas faladas sem precisar instalar software no computador.
Diferente dos serviços de TTS hospedados que incluem os custos do modelo em uma assinatura, o SpeechGPT roda no navegador e cobra apenas pelas contas OpenAI, Azure Speech Services ou Amazon Polly que você conectar. Isso o torna uma opção leve para desenvolvedores e estudantes de idiomas que já possuem acesso à API e querem uma interface simples de chat por voz.
A interface suporta rótulos de UI em inglês, espanhol e chinês, inclui um botão de gravação para entrada por voz e armazena os dados da sessão localmente no navegador. É adequado para desenvolvedores testando fluxos de chat por voz, estudantes de idiomas praticando comandos falados e qualquer pessoa que queira um cliente de voz ChatGPT minimalista no celular ou desktop.
VALL-E
O que é VALL-E?
VALL-E é um modelo de texto para fala da Microsoft Research que clona a voz de um locutor a partir de um curto clipe de áudio e gera nova fala a partir do texto. Pertence à categoria de geração de áudio porque sintetiza fala natural em vez de editar gravações existentes. A página do projeto hospeda áudios de exemplo para o modelo original VALL-E e variantes posteriores da mesma família de pesquisa.
A maioria dos sistemas TTS regredem formas de onda contínuas ou mel-espectrogramas diretamente. VALL-E, em vez disso, trata a fala como uma tarefa de modelagem condicional de linguagem sobre códigos discretos de um codec neural de áudio. A Microsoft o treinou com cerca de 60.000 horas de fala em inglês, muito maior que os conjuntos de dados típicos de TTS. Uma gravação de 3 segundos de um locutor não visto é suficiente para conduzir a síntese zero-shot, e o modelo pode manter a emoção e o tom ambiente presentes nesse prompt.
A família VALL-E cresceu além do primeiro artigo. VALL-E X lida com TTS zero-shot cross-lingual, VALL-E R adiciona alinhamento monotônico de fonemas para uma geração de fala mais estável, e VALL-E 2 combina amostragem consciente de repetição com modelagem de código agrupado para alcançar paridade humana nos benchmarks LibriSpeech e VCTK. Linhas relacionadas como MELLE, FELLE e PALLE exploram tokens mel contínuos e decodificação híbrida autoregressiva mais paralela.
Pesquisadores, engenheiros de fala e ouvintes curiosos usam VALL-E para ouvir o que modelos de linguagem de codec em larga escala podem fazer antes de construir seus próprios pipelines. As amostras públicas são demos de pesquisa, não uma API hospedada que você pode integrar a um produto sem licenciamento e revisão ética separada.
SpeechGPT Votos positivos
VALL-E Votos positivos
SpeechGPT Recursos principais
Interface de chat aceita mensagens digitadas ou entrada de fala gravada com Enter para enviar
Requer sua chave API OpenAI nas configurações antes que o aplicativo inicie conversas
Chaves de acesso opcionais aos Serviços de Fala Azure ou Amazon Polly para backends de texto para fala alternativos
UI disponível em Inglês, Espanhol e Chinês no seletor de idioma do aplicativo
Shift mais Enter insere uma nova linha sem enviar a mensagem
Executa como um aplicativo web no Vercel sem necessidade de instalação separada no desktop
VALL-E Recursos principais
Clona um alto-falante não visto a partir de um prompt de áudio de 3 segundos registrado
Pré-treinado em cerca de 60.000 horas de dados de fala em inglês
VALL-E 2 relata paridade humana nos benchmarks zero-shot LibriSpeech e VCTK
Preserva a emoção do alto-falante e o ambiente acústico do trecho do prompt
VALL-E X estende a síntese zero-shot para cenários cross-lingua
As páginas de amostra cobrem sete linhas de modelos incluindo MELLE, FELLE e PALLE
SpeechGPT Categoria
- Audio Generation
VALL-E Categoria
- Audio Generation
SpeechGPT Tipo de tarifação
- Free
VALL-E Tipo de tarifação
- Free