AnyToSpeech 对比 MusicLM
在 AnyToSpeech 和 MusicLM 的对决中,哪个 AI Audio Generation 工具脱颖而出?我们评估评论、定价、替代品、功能、赞成票等等。
当我们把 AnyToSpeech 和 MusicLM 放在一起时,哪一个会成为胜利者?
让我们仔细看看AnyToSpeech和MusicLM,两者都是AI驱动的audio generation工具,看看它们有什么不同。 就赞成票而言,没有明显的赢家,因为这两种工具都获得了相同的数量。 您的投票很重要!通过投票帮助我们决定 aitools.fyi 用户中的获胜者。
认为我们错了?投票并向我们展示谁才是老大!
AnyToSpeech
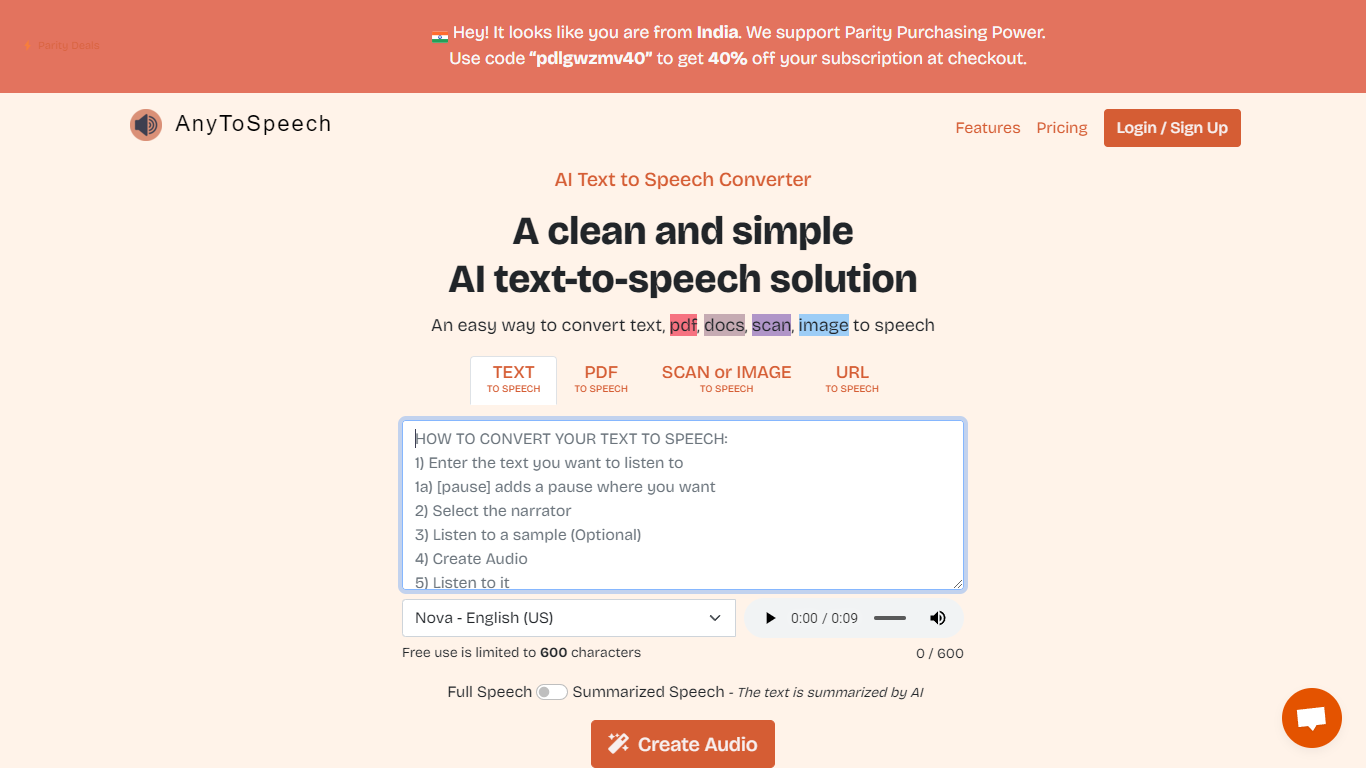

什么是 AnyToSpeech?
AnyToSpeech是一个在线文本转语音平台,将书面内容转换成语音。你可以粘贴纯文本、上传PDF、提供网址链接,或者从图片中提取文本,然后得到自然声音的MP3文件。
该平台远超基础的TTS(文本转语音)功能。你可以制作PDF和文档有声书、旁白网页、进行语音转文字的转录、克隆你的声音(从短录音中学习)以及从主题简介或剧本生成双声道播客节目。PDF转换时会跳过页码、脚注和目录部分,保持听觉流畅。
AnyToSpeech提供数百种不同语言和口音的语音选择,以及大量免费分析工具,用于发音、口音检测和声音评分。移动应用在Google Play和Apple App Store上均有提供。
它适合创作者、作者、教育者以及任何希望听而非读的人。
MusicLM
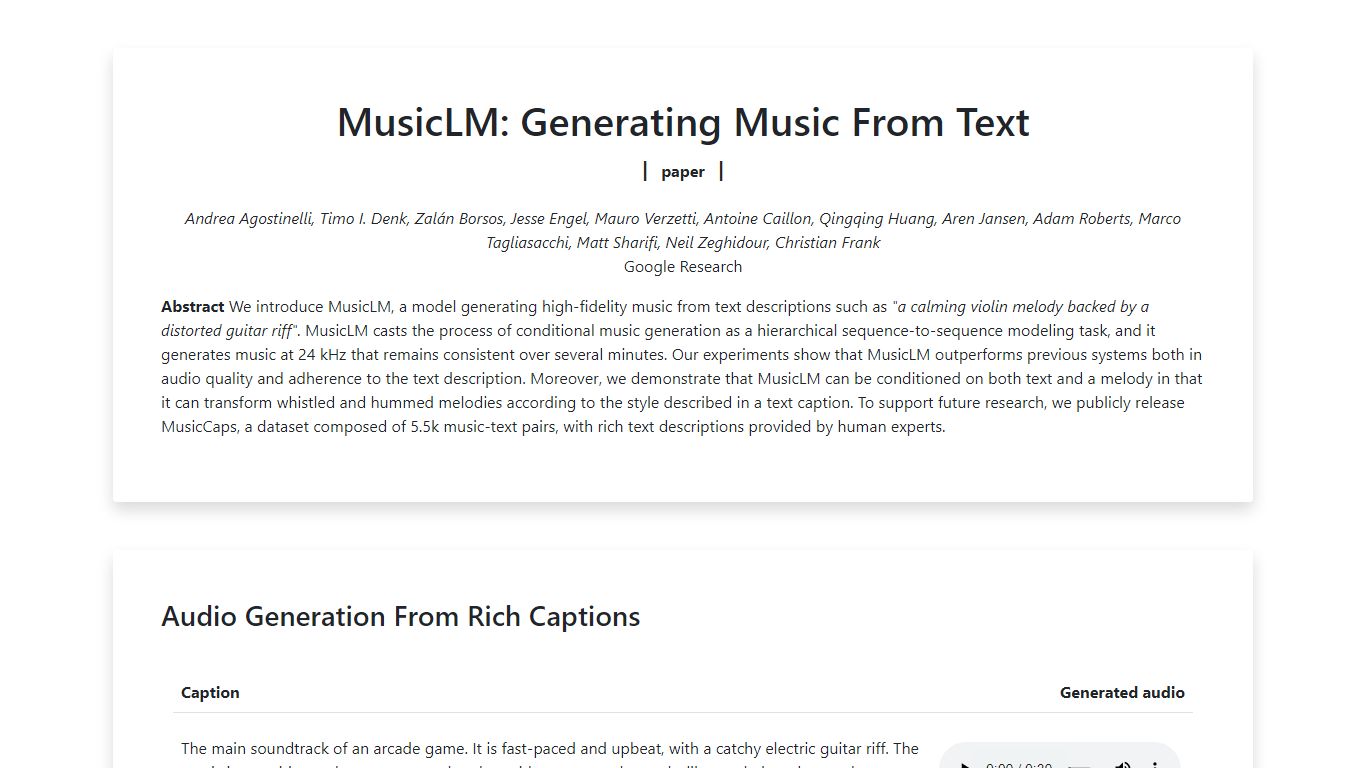
什么是 MusicLM?
MusicLM 是谷歌研究团队开发的音频生成模型,能够根据文本描述以 24 kHz 采样率创作音乐。公开示例页面提供了多种提示的样本片段,如街机游戏原声、雷鬼与电子舞曲融合以及轻松的爵士乐,还有跨时段风格变化的长篇故事模式生成。谷歌在论文发布的同时,公开了包含 5,500 对音乐与文本的 MusicCaps 数据集。
不同于只提供单一提示框的消费级应用,MusicLM 作为研究演示发布,展示了预生成样本,而非登录使用的产品。其核心技术是文本与旋律的联合条件控制:用户可以哼唱或吹口哨一段旋律,模型会根据文本描述将其重新演绎成新的音乐风格。故事模式则通过串联多个文本提示,使音乐在不同段落中演变。
MusicLM 是谷歌后续 Lyria 音乐模型的研究基础,但本页面仅供试听已发布示例,不支持交互式创作新曲。研究人员和音乐人关注其在长篇一致性、绘画到音乐的条件控制以及旋律迁移方面的表现,这些成果已在 2023 年的论文中记录。
AnyToSpeech 赞同数
MusicLM 赞同数
AnyToSpeech 顶级功能
粘贴文本或上传PDF、DOCX和网址,然后下载经过润色的MP3音频,支持可调节语速
通过三段简短录音约30秒内克隆您的声音,并在所有转换工具中使用
根据主题或脚本生成双主播播客节目,包含开场音乐和口播标题
上传音频或视频文件进行转录,支持翻译成100多种语言,每月免费享受50分钟转录时间
从超过24种界面语言的数百种声音中选择,包括全球各地区的特定口音
MusicLM 顶级功能
从丰富的文本字幕生成 24 kHz 音乐
故事模式在定时段内链结多个文本提示
文本与旋律条件化将哼唱或吹口哨的旋律转变为新风格
绘画字幕条件化将艺术作品描述与生成的音频配对
长时间生成示例涵盖旋律电子、摇摆和放松爵士
MusicCaps 数据集包括 5500 对专家撰写的音乐-文本配对
AnyToSpeech 类别
- Audio Generation
MusicLM 类别
- Audio Generation
AnyToSpeech 定价类型
- Freemium
MusicLM 定价类型
- Free