Audyo 对比 MusicLM
在 Audyo 和 MusicLM 的对决中,哪个 AI Audio Generation 工具是冠军?我们评估定价、替代品、赞成票、功能、评论等等。
如果你必须在 Audyo 和 MusicLM 之间做出选择,你会选择哪一个?
当我们检查Audyo和MusicLM时,两者都是AI启用的audio generation工具,我们会发现什么独特的特征? 正如相同的点赞数所示,这两种工具都同样受到青睐。 加入 aitools.fyi 用户,通过投票决定获胜者。
不是你的菜?投票支持您喜欢的工具,搅动事情!
Audyo
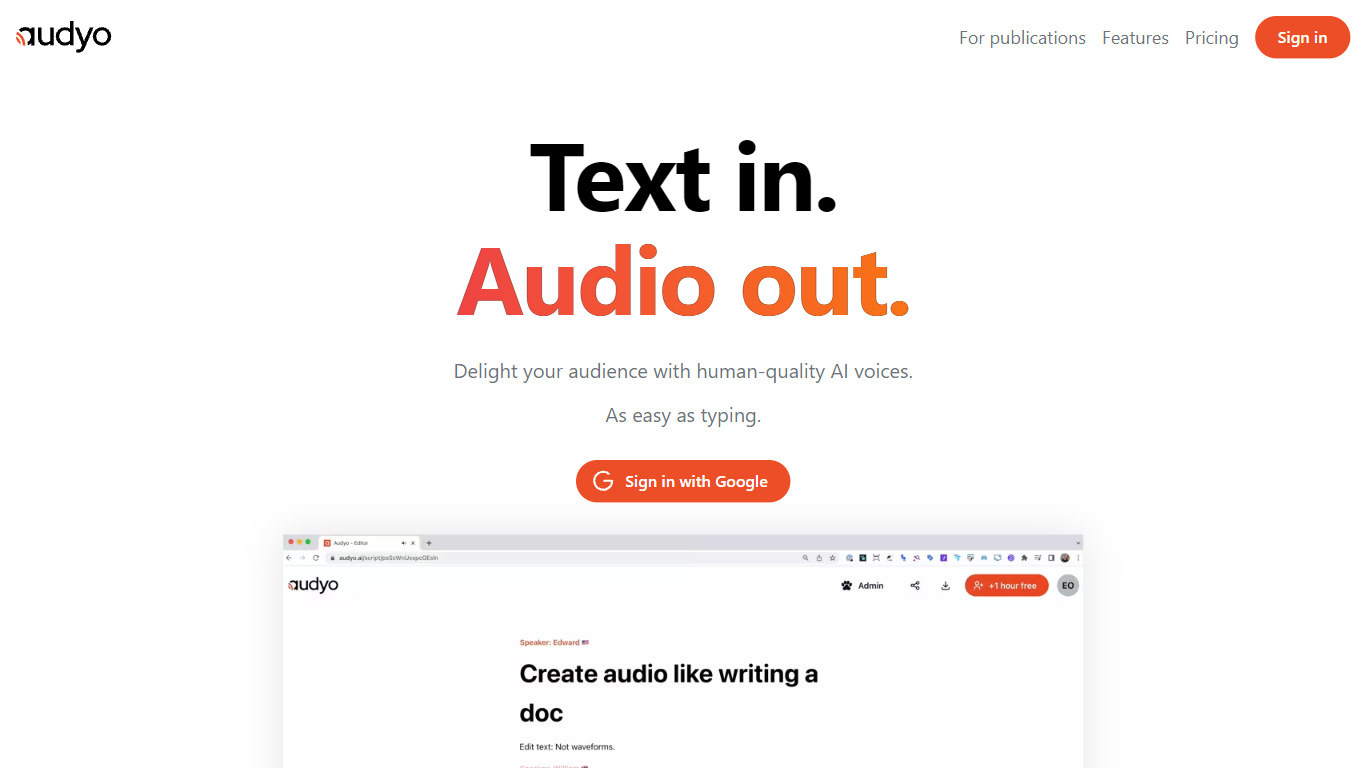

什么是 Audyo?
Audyo 是一款文本转语音编辑器,可以像编辑文档一样轻松地将书面脚本转换为语音音频。您编辑的是文字而非波形,可以在 100 多种不同口音和语言的声音之间切换,并导出用于视频、播客或演示的文件。Markdown 标题、列表和水平分隔线在段落之间添加停顿,无需打开单独的音频时间线。
传统的配音工具需要手动剪辑波形和管理轨道。Audyo 将音频视为文档:快速选择功能让您通过内联切换声音来构建多角色对话,语音覆盖功能逐字修正发音难点,AI 音频助手帮助在编辑器内重写脚本。该工作流程适合先以文本思考、只需干净音频输出的创作者。
播客主持人和视频编辑使用 Audyo 进行配音,无需录音棚。有声书作者在一个项目中混合使用英语、西班牙语、印地语及其他 10 多种支持语言。该网站报告平台上有近 70,000 名创作者,使用场景涵盖视频、播客、有声书和一般配音工作。
MusicLM
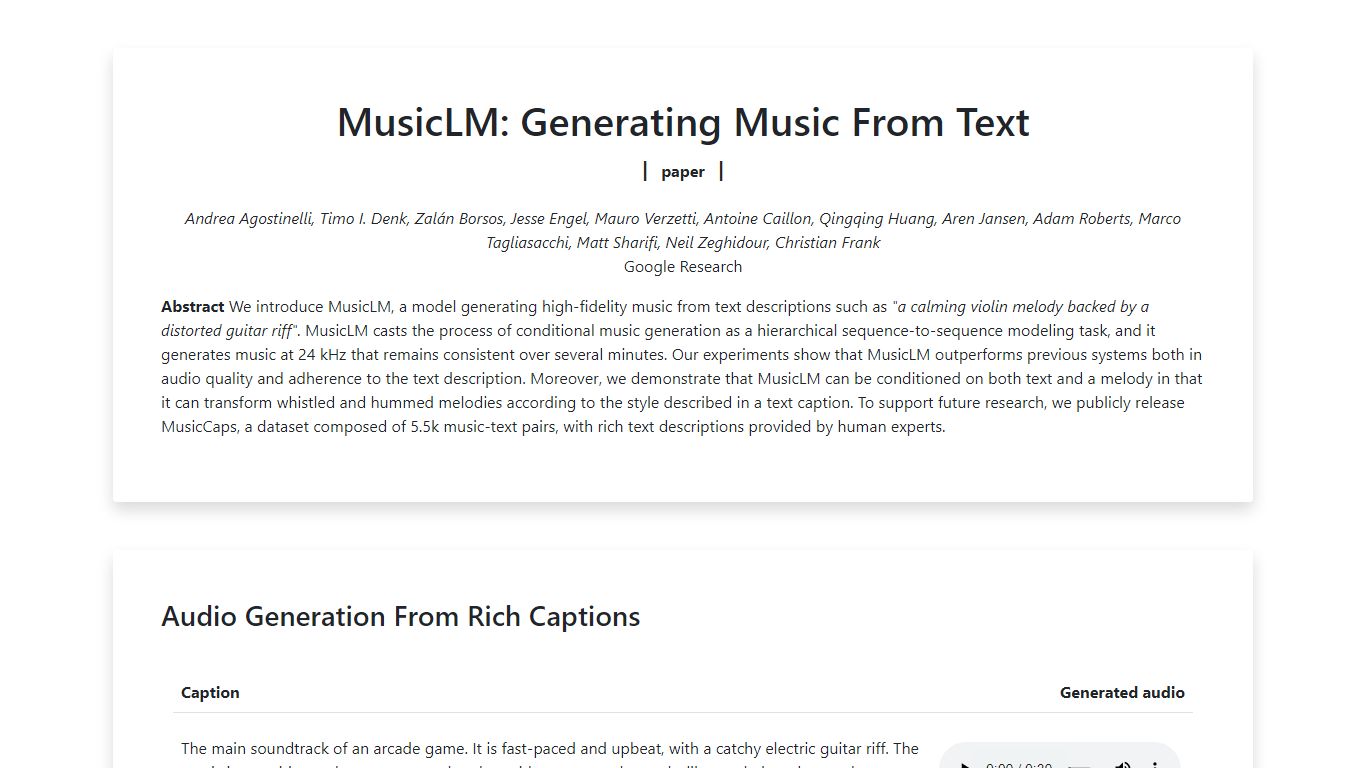
什么是 MusicLM?
MusicLM 是谷歌研究团队开发的音频生成模型,能够根据文本描述以 24 kHz 采样率创作音乐。公开示例页面提供了多种提示的样本片段,如街机游戏原声、雷鬼与电子舞曲融合以及轻松的爵士乐,还有跨时段风格变化的长篇故事模式生成。谷歌在论文发布的同时,公开了包含 5,500 对音乐与文本的 MusicCaps 数据集。
不同于只提供单一提示框的消费级应用,MusicLM 作为研究演示发布,展示了预生成样本,而非登录使用的产品。其核心技术是文本与旋律的联合条件控制:用户可以哼唱或吹口哨一段旋律,模型会根据文本描述将其重新演绎成新的音乐风格。故事模式则通过串联多个文本提示,使音乐在不同段落中演变。
MusicLM 是谷歌后续 Lyria 音乐模型的研究基础,但本页面仅供试听已发布示例,不支持交互式创作新曲。研究人员和音乐人关注其在长篇一致性、绘画到音乐的条件控制以及旋律迁移方面的表现,这些成果已在 2023 年的论文中记录。
Audyo 赞同数
MusicLM 赞同数
Audyo 顶级功能
从100多种AI语音中选择,包括美国、英国、爱尔兰、法语、西班牙语、普通话、印地语等多种口音
像编辑文档一样编辑脚本,支持Markdown标题、列表和分隔符暂停,而非波形剪辑
快速选择在行内切换说话人,快速构建多声道对话和会话
每个单词的自定义音标拼写,修正发音,无需重新录制整句
支持13+种语言,包括英语、法语、西班牙语、德语、意大利语、葡萄牙语、日语、韩语、汉语、印地语、阿拉伯语、土耳其语和俄语
即时音频导出,可用于视频、播客或演示文稿
MusicLM 顶级功能
从丰富的文本字幕生成 24 kHz 音乐
故事模式在定时段内链结多个文本提示
文本与旋律条件化将哼唱或吹口哨的旋律转变为新风格
绘画字幕条件化将艺术作品描述与生成的音频配对
长时间生成示例涵盖旋律电子、摇摆和放松爵士
MusicCaps 数据集包括 5500 对专家撰写的音乐-文本配对
Audyo 类别
- Audio Generation
MusicLM 类别
- Audio Generation
Audyo 定价类型
- Freemium
MusicLM 定价类型
- Free