ImageToPromptAI 对比 Diffus (formerly GRAVITI Diffus)
探索 ImageToPromptAI 和 Diffus (formerly GRAVITI Diffus) 的对决,找出哪个 AI Design 工具获胜。我们分析赞成票、功能、评论、定价、替代品等等。
在比较 ImageToPromptAI 和 Diffus (formerly GRAVITI Diffus) 时,哪一个超越了另一个?
当我们将ImageToPromptAI与Diffus (formerly GRAVITI Diffus)进行对比时,两者都是AI操作的design工具,并将它们并排放置时,我们可以发现几个重要的相似之处和分歧。 正如相同的点赞数所示,这两种工具都同样受到青睐。 权力掌握在你手中!投票并参与决定获胜者。
不是你的菜?投票支持您喜欢的工具,搅动事情!
ImageToPromptAI
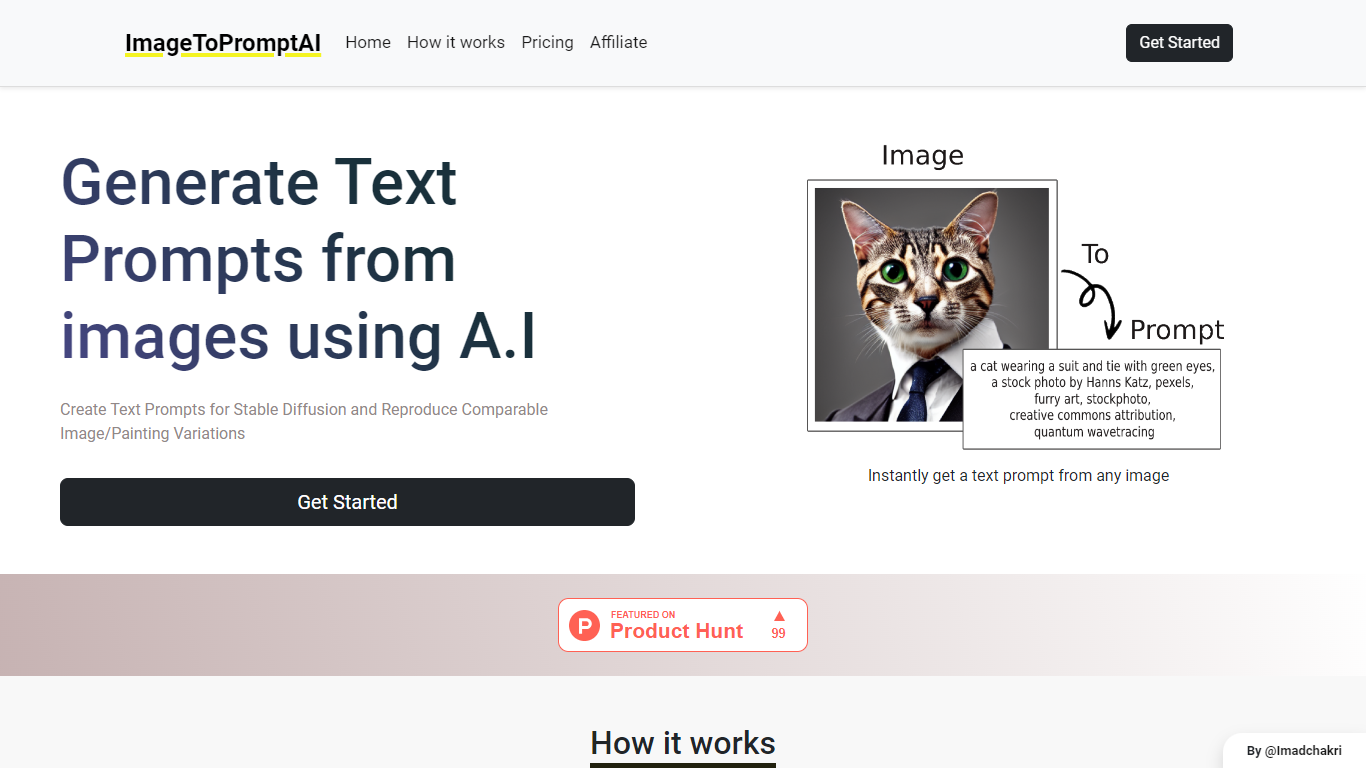

什么是 ImageToPromptAI?
ImageToPromptAI 提供创新服务,将您的图像转换为文本提示,以满足使用 Stable Diffusion 等 AI 模型进行多功能创意项目的用户的需求。通过上传图像,您可以立即收到相应的文本提示,可用于生成类似的图像或绘画变体。
这项服务取消了订阅,允许您根据特定需求按需付费。无论是个人享受还是专业用途,ImageToPromptAI 都可以简化从视觉到文本输入的跨媒体转换过程。
Diffus (formerly GRAVITI Diffus)
什么是 Diffus (formerly GRAVITI Diffus)?
Diffus 让您可以在浏览器中使用 Stable Diffusion、SDXL、SD3 和 Flux 模型生成和编辑图像。可从 70,000 多个检查点、LoRA 和嵌入中选择,然后无需购买自己的 GPU 即可运行云端生成。工作区集成了 ControlNet、修补、ADetailer 面部修复、自定义模型上传、ComfyUI 工作流以及 Flux 和视频输出的独立工具。
Midjourney 或 DALL·E 将您限制在单一模型堆栈中,而 Diffus 更像是一个托管的 Stable Diffusion 实验室。您可以浏览社区模型,在更高等级上传私有模型,并根据计划调整采样步数、推理时间和并发作业数量。这种深度以控制换取简洁,适合已经熟悉提示语法和扩展名称的艺术家。
设计师、插画师和营销团队使用 Diffus 进行概念艺术、产品模型、面部修正肖像和短视频剪辑。Teaser 计划的爱好者每天获得积分进行试验,而 Pro 订阅者则享有微调、40GB 私人存储和包含 ComfyUI 的可重复管道。
ImageToPromptAI 赞同数
Diffus (formerly GRAVITI Diffus) 赞同数
ImageToPromptAI 顶级功能
**将图像转换为文本:**立即将图像转换为 AI 模型的提示。
按使用量付费定价:灵活的付款模式,无需订阅。
多个层级:根据您的需求从基本、专业或超级计划中进行选择。
易于使用:用于上传图像和生成提示的简单界面。
无需帐户:无需用户帐户即可开始使用该服务。
Diffus (formerly GRAVITI Diffus) 顶级功能
在一个浏览器工作区中浏览并运行70,000多个公共检查点、LoRAs和嵌入
ControlNet、修复、ADetailer和Couple扩展,用于构图和面部细化
Plus和Pro计划解锁SD3、Flux、视频生成和每月最多36,000积分
在Plus(25GB存储)和Pro(50GB存储)层上传私人模型
Pro包含ComfyUI工作流程;在Basic和Plus上作为附加组件提供
Pro计划支持微调和带声音的高级视频模型
ImageToPromptAI 类别
- Design
Diffus (formerly GRAVITI Diffus) 类别
- Design
ImageToPromptAI 定价类型
- Freemium
Diffus (formerly GRAVITI Diffus) 定价类型
- Paid