TLM Playground 对比 Plumb
在 TLM Playground 和 Plumb 的对决中,哪个 AI Model Generation 工具脱颖而出?我们评估评论、定价、替代品、功能、赞成票等等。
当我们把 TLM Playground 和 Plumb 放在一起时,哪一个会成为胜利者?
让我们仔细看看TLM Playground和Plumb,两者都是AI驱动的model generation工具,看看它们有什么不同。 正如相同的点赞数所示,这两种工具都同样受到青睐。 加入 aitools.fyi 用户,通过投票决定获胜者。
结果让你说“嗯”?投票,把那个皱眉头变成笑脸!
TLM Playground

什么是 TLM Playground?
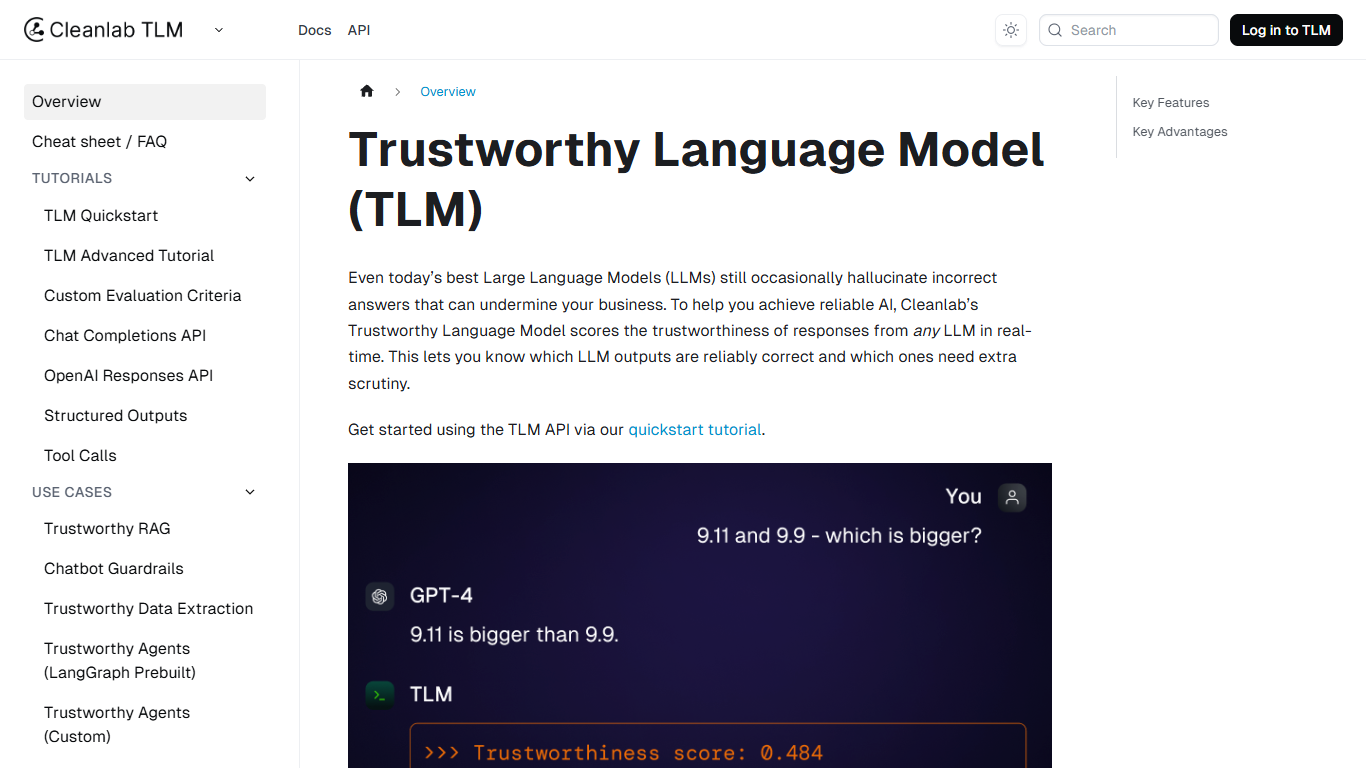
TLM Playground 是 Cleanlab 为可信语言模型(TLM)提供的文档中心。TLM 是一个模型生成 API,能够实时评估任何大型语言模型(LLM)响应的可靠性。每个答案都会获得一个介于 0 到 1 之间的可信度评分,在错误生成和推理错误到达用户之前进行标记。通过 pip install cleanlab-tlm 安装 Python 客户端,设置 CLEANLAB_TLM_API_KEY,然后调用 TLM.prompt() 生成带评分的响应,或调用 get_trustworthiness_score() 审核您现有系统的输出。
大多数幻觉检测器侧重于与检索上下文的一致性。像 RAGAS 这样的指标检查答案是否与源文档匹配,但在上下文稀少或混乱时容易遗漏事实错误。TLM 使用模型不确定性估计,而非以 LLM 作为评判者的提示,Cleanlab 发布的基准测试显示其在 RAG 工作流中的精确度是 RAGAS 的 3 倍。它不需要您领域的标注训练数据,从而避免了导致自定义评估器失效的漂移问题。
构建 RAG 流水线、聊天机器人和代理系统的机器学习与人工智能工程师使用 TLM 来筛选低置信度输出,将其转交人工处理,或替换为备用答案。该 API 支持结构化输出、工具调用、分类标签和多轮对话,而不仅限于纯文本补全。
Plumb

什么是 Plumb?
Plumb 让 AI 顾问能够通过可视化节点编辑器构建、部署和销售自主工作流程,无需编写代码。每个流程都有自己的前端,按需或自动运行,并接受文本、音频、图像和视频输入。访问需通过 signup.useplumb.com 的私人测试申请。
当通用工作流程工具仅限于内部任务时,Plumb 面向销售 AI 服务的人群。你可以发布流程,推送更新而无需克隆副本,设置一次性费用、订阅或按次收费的付费墙,并分享推广页面。该以顾问为先的变现层是其与广泛无代码自动化套件的主要区别。
自由职业 AI 顾问、代理团队和内部推动者,尤其是那些原型多模态模型管道的用户,最适合使用。流程可根据条件分支,并将输出路由至电子邮件、短信或 Slack。
TLM Playground 赞同数
Plumb 赞同数
TLM Playground 顶级功能
每个响应返回一个0到1的可信度分数,通过不确定性估计计算得出
get_trustworthiness_score() 在不改变推理代码的情况下对任何LLM的输出进行评分
TLM.prompt() 在一次API调用中返回响应和评分,默认以gpt-4.1-mini作为基础模型
基准测试报告显示比RAGAS少27%的错误GPT-4o响应和3倍的RAG错误检测提升
从低到高的质量预设,加上TLM Lite,让你在延迟和成本与评分深度之间权衡
TrustworthyRAG Evals 评分基础性、回避性和上下文充分性,以及可信度
Plumb 顶级功能
免费层包括50次运行和200个AI积分,每月0美元,适用于一名用户
Pro计划每月49美元,包括500次运行和2,000个AI积分,适用于一名用户
Team计划每月249美元,支持无限用户,提供每月2,000次运行
内置节点支持Perplexity、Exa、OpenAI、Anthropic、ElevenLabs和AssemblyAI
每个流程都配备自己的前端和可选的人机审核
版本控制跟踪更改,发布将更新推送给所有关联用户
任何AI步骤都提供结构化JSON架构输出,确保下游数据可靠
TLM Playground 类别
- Model Generation
Plumb 类别
- Model Generation
TLM Playground 定价类型
- Freemium
Plumb 定价类型
- Freemium