APIPark vs wav2vec 2.0
Lors de la comparaison de APIPark vs wav2vec 2.0, quel outil AI Large Language Model (LLM) brille le plus? Nous examinons les prix, les alternatives, les votes positifs, les fonctionnalités, les avis, et bien plus.
Entre APIPark et wav2vec 2.0, lequel est supérieur?
Quand nous mettons APIPark et wav2vec 2.0 côte à côte, tous deux étant des outils large language model (llm) alimentés par l'IA, Les deux outils ont reçu le même nombre de votes positifs des utilisateurs de aitools.fyi. Chaque vote compte ! Faites le vôtre et contribuez à la décision du gagnant.
Vous pensez que nous avons tort? Votez et montrez-nous qui est le patron!
APIPark
Qu'est-ce que APIPark?
APIPark est une passerelle LLM open-source et un portail développeur d'API pour les entreprises qui ont besoin d'un seul endroit pour appeler, gérer et facturer les modèles d'IA et les API internes. Il dirige le trafic vers plus de 200 grands modèles de langage via un point d'accès unique compatible OpenAI, afin que les équipes cessent de connecter des SDK de fournisseurs séparés pour chaque modèle ajouté.
Alors que la plupart des passerelles API ne font que transférer les requêtes, APIPark considère également les modèles et les API comme des actifs négociables. Il intègre une authentification unifiée, des flux d'approbation, une facturation par recharge, une distribution à plusieurs niveaux et des rapports de profit afin que les équipes plateformes puissent vendre la capacité excédentaire des modèles ou regrouper des API métier sans construire une infrastructure de marché séparée.
Les ingénieurs plateforme et les équipes IA l'utilisent pour définir des quotas par locataire, des limites de débit et des règles de masquage avant que le trafic de production n'atteigne les modèles en amont. Les gestionnaires d'API disposent de portails pour publier des API, suivre l'utilisation et approuver les demandes d'accès. L'édition Community couvre les fonctionnalités principales de la passerelle et du portail ; l'édition Enterprise ajoute une gouvernance avancée, des statistiques d'exécution et un support premium.
wav2vec 2.0
Qu'est-ce que wav2vec 2.0?
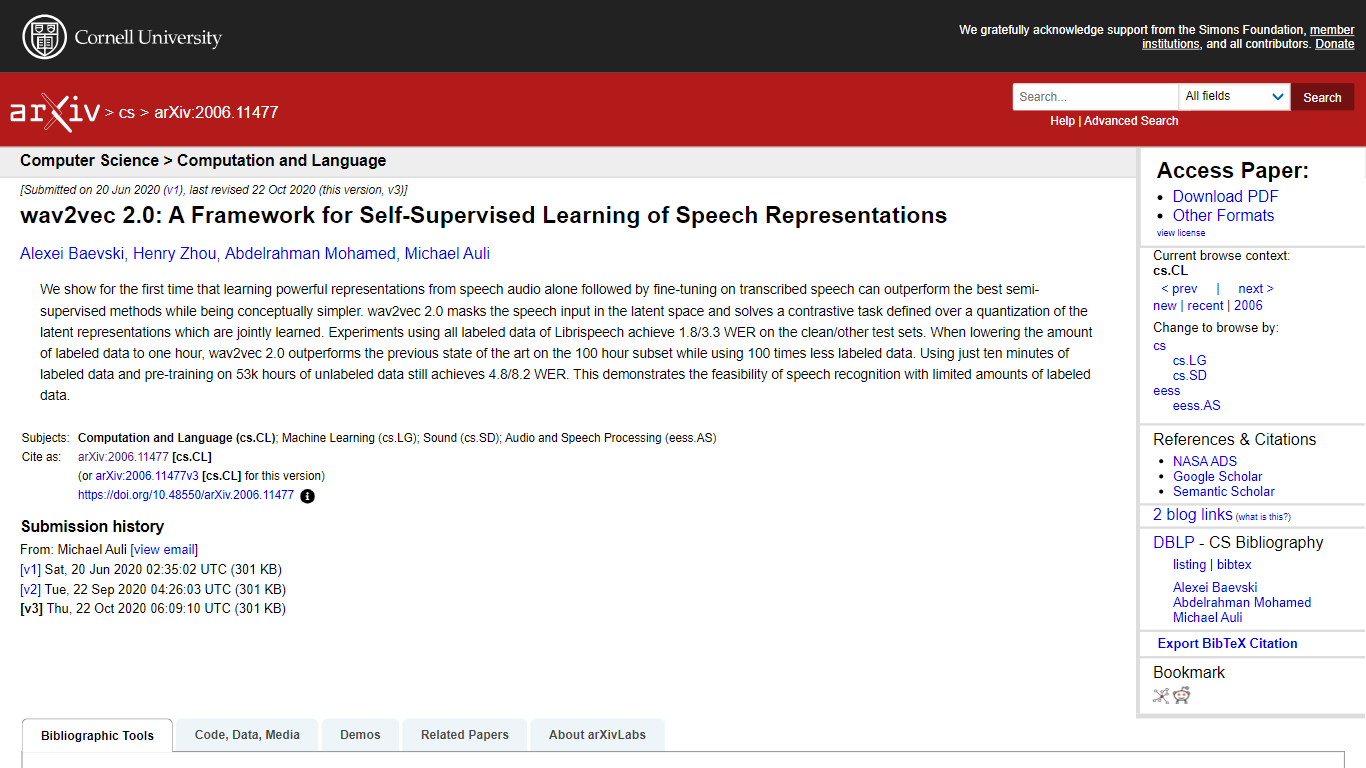
wav2vec 2.0 est un cadre d'apprentissage auto-supervisé qui apprend des représentations de la parole directement à partir de l'audio brut. Il masque des portions de l'entrée audio dans un espace latent et résout une tâche contrastive sur des représentations latentes quantifiées, qui sont apprises conjointement avec le modèle. Cette approche permet au modèle de tirer parti efficacement de grandes quantités de données audio non étiquetées. Après pré-entraînement, wav2vec 2.0 peut être affiné sur de petites quantités de données audio étiquetées pour atteindre des performances de reconnaissance vocale à la pointe de la technologie. Le modèle a démontré de bons résultats même lorsqu'il est affiné avec seulement quelques minutes d'audio étiqueté, ce qui le rend très efficace pour les scénarios à faibles ressources.
Le cadre simplifie la reconnaissance vocale en supprimant la nécessité de pipelines semi-supervisés complexes, en s'appuyant plutôt sur un seul modèle de bout en bout. Il atteint des taux d'erreur word impressionnants sur des benchmarks standard comme Librispeech et TIMIT, surpassant les méthodes précédentes qui nécessitent beaucoup plus de données étiquetées. La quantification des représentations de la parole latentes permet au modèle d'apprendre des unités de parole discrètes, ce qui améliore la robustesse et la généralisation.
wav2vec 2.0 cible les chercheurs et les développeurs travaillant sur la reconnaissance vocale, en particulier ceux qui souhaitent exploiter des données audio non étiquetées pour réduire les coûts d'annotation. Sa capacité à bien fonctionner avec peu de données étiquetées ouvre des opportunités pour construire des systèmes de reconnaissance dans des langues ou des domaines à faibles ressources. L'architecture du modèle repose sur des encodeurs de caractéristiques convolutifs et des réseaux Transformer, lui permettant de capturer à la fois les motifs locaux et globaux de la parole.
Techniquement, wav2vec 2.0 combine l'apprentissage contrastif avec une stratégie de masquage appliquée dans l'espace latent, ce qui diffère des approches précédentes qui masquent directement l'audio d'entrée. Ce choix de conception améliore la qualité des représentations apprises. Le modèle est entraîné sur de grands ensembles de données non étiquetées, comme 53 000 heures de parole, puis affiné sur des sous-ensembles plus petits avec étiquettes. Ce processus d'entraînement en deux étapes équilibre évolutivité et précision.
Dans l'ensemble, wav2vec 2.0 représente une avancée majeure dans l'apprentissage de représentations de la parole auto-supervisé. Il réduit la dépendance aux données étiquetées, simplifie les pipelines d'entraînement et atteint des performances comparables ou supérieures à celles des méthodes entièrement supervisées ou semi-supervisées. La sortie du code et des modèles pré-entraînés facilite son adoption et la recherche future en technologie vocale.
APIPark Votes positifs
wav2vec 2.0 Votes positifs
APIPark Fonctionnalités principales
Routage de plus de 200 LLM via une seule signature d'API compatible OpenAI pour que le code client existant n'ait pas besoin de réécritures spécifiques au fournisseur
Déployez la passerelle et le portail développeur en environ 5 minutes avec une seule commande en ligne de commande
L'équilibrage de charge répartit les requêtes entre les instances LLM pour maintenir la tolérance aux pannes et la prédictibilité du débit sous charge
La facturation API intégrée suit la consommation par utilisateur pour permettre aux équipes de mesurer et monétiser l'accès API interne ou partenaire
Les quotas précis limitent les dépenses quotidiennes ou mensuelles par montant, tokens ou nombre d'appels pour bloquer l'utilisation excessive du modèle
Le moteur de masquage des données signale et masque les champs sensibles dans les charges utiles des requêtes et réponses pour la conformité
wav2vec 2.0 Fonctionnalités principales
Le pré-entraînement auto-supervisé sur audio brut 🎧 permet d'apprendre à partir de données vocales non étiquetées
Le masquage de l'espace latent 🎭 améliore la concentration du modèle sur le contexte et sa robustesse
La tâche contrastive sur des représentations quantifiées 🔄 aide à apprendre des unités vocales discrètes
Le fine-tuning avec un minimum de données étiquetées 📝 atteint une forte précision en reconnaissance vocale
L'architecture basée sur un Transformer 🔗 capture efficacement les dépendances à longue portée du discours
APIPark Catégorie
- Large Language Model (LLM)
wav2vec 2.0 Catégorie
- Large Language Model (LLM)
APIPark Type de tarification
- Freemium
wav2vec 2.0 Type de tarification
- Freemium