Claude 3 \ Anthropic vs wav2vec 2.0
Comparez Claude 3 \ Anthropic vs wav2vec 2.0 et voyez quel outil AI Large Language Model (LLM) est meilleur lorsque nous comparons les fonctionnalités, les avis, les prix, les alternatives, les votes positifs, etc.
Lequel est meilleur? Claude 3 \ Anthropic ou wav2vec 2.0?
Quand nous comparons Claude 3 \ Anthropic avec wav2vec 2.0, qui sont tous deux des outils large language model (llm) alimentés par l'IA, Dans la course aux votes positifs, Claude 3 \ Anthropic remporte le trophée. Claude 3 \ Anthropic a attiré 8 votes positifs des utilisateurs de aitools.fyi, et wav2vec 2.0 a attiré 6 votes positifs.
Vous n'êtes pas d'accord avec le résultat? Votez pour nous aider à décider!
Claude 3 \ Anthropic
Qu'est-ce que Claude 3 \ Anthropic?
Claude 3 est la famille de modèles linguistiques de troisième génération d'Anthropic, lancée en mars 2024. Elle comprend trois niveaux : Haiku pour la vitesse et le coût, Sonnet pour un rendement équilibré, et Opus pour la profondeur de raisonnement maximale. Chaque modèle cible un compromis différent entre intelligence, latence et prix.
La famille gère des tâches de texte, de code, d'analyse et de vision. Les modèles Claude 3 traitent les photos, les graphiques, les diagrammes et les diagrammes techniques. Ils prennent en charge une fenêtre de contexte de 200 000 tokens au lancement, avec des entrées dépassant 1 million de tokens disponibles pour certains clients. Opus et Sonnet ont été lancés sur claude.ai et l'API Claude dans 159 pays, suivis peu après par Haiku.
Anthropic a construit Claude 3 avec des méthodes de sécurité AI Constitutionnelle et des garde-fous de la Politique de Scaling Responsable. Les modèles sont disponibles via l'API Claude, Amazon Bedrock et Google Cloud Vertex AI. Sonnet alimente le niveau gratuit sur claude.ai, tandis qu'Opus est réservé aux abonnés Claude Pro.
wav2vec 2.0
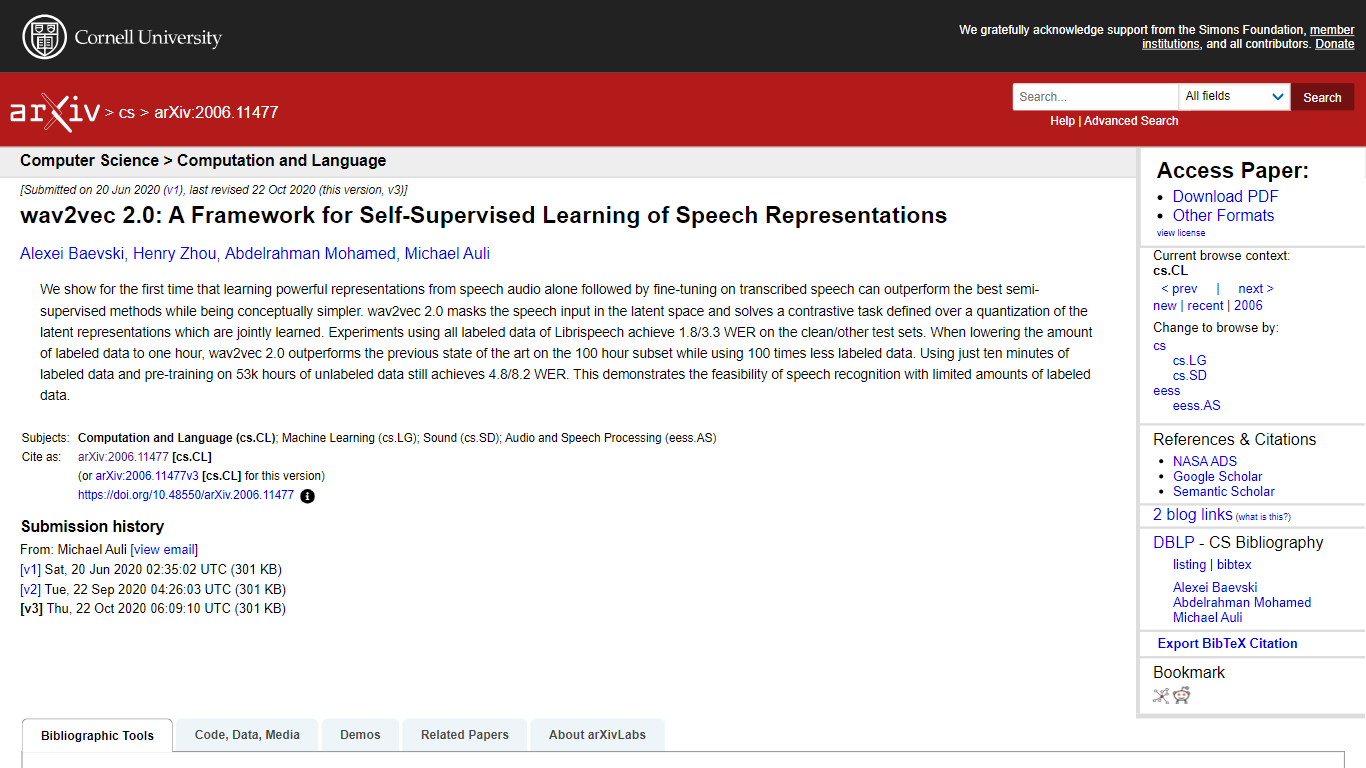
Qu'est-ce que wav2vec 2.0?
wav2vec 2.0 est un cadre d'apprentissage auto-supervisé qui apprend des représentations de la parole directement à partir de l'audio brut. Il masque des portions de l'entrée audio dans un espace latent et résout une tâche contrastive sur des représentations latentes quantifiées, qui sont apprises conjointement avec le modèle. Cette approche permet au modèle de tirer parti efficacement de grandes quantités de données audio non étiquetées. Après pré-entraînement, wav2vec 2.0 peut être affiné sur de petites quantités de données audio étiquetées pour atteindre des performances de reconnaissance vocale à la pointe de la technologie. Le modèle a démontré de bons résultats même lorsqu'il est affiné avec seulement quelques minutes d'audio étiqueté, ce qui le rend très efficace pour les scénarios à faibles ressources.
Le cadre simplifie la reconnaissance vocale en supprimant la nécessité de pipelines semi-supervisés complexes, en s'appuyant plutôt sur un seul modèle de bout en bout. Il atteint des taux d'erreur word impressionnants sur des benchmarks standard comme Librispeech et TIMIT, surpassant les méthodes précédentes qui nécessitent beaucoup plus de données étiquetées. La quantification des représentations de la parole latentes permet au modèle d'apprendre des unités de parole discrètes, ce qui améliore la robustesse et la généralisation.
wav2vec 2.0 cible les chercheurs et les développeurs travaillant sur la reconnaissance vocale, en particulier ceux qui souhaitent exploiter des données audio non étiquetées pour réduire les coûts d'annotation. Sa capacité à bien fonctionner avec peu de données étiquetées ouvre des opportunités pour construire des systèmes de reconnaissance dans des langues ou des domaines à faibles ressources. L'architecture du modèle repose sur des encodeurs de caractéristiques convolutifs et des réseaux Transformer, lui permettant de capturer à la fois les motifs locaux et globaux de la parole.
Techniquement, wav2vec 2.0 combine l'apprentissage contrastif avec une stratégie de masquage appliquée dans l'espace latent, ce qui diffère des approches précédentes qui masquent directement l'audio d'entrée. Ce choix de conception améliore la qualité des représentations apprises. Le modèle est entraîné sur de grands ensembles de données non étiquetées, comme 53 000 heures de parole, puis affiné sur des sous-ensembles plus petits avec étiquettes. Ce processus d'entraînement en deux étapes équilibre évolutivité et précision.
Dans l'ensemble, wav2vec 2.0 représente une avancée majeure dans l'apprentissage de représentations de la parole auto-supervisé. Il réduit la dépendance aux données étiquetées, simplifie les pipelines d'entraînement et atteint des performances comparables ou supérieures à celles des méthodes entièrement supervisées ou semi-supervisées. La sortie du code et des modèles pré-entraînés facilite son adoption et la recherche future en technologie vocale.
Claude 3 \ Anthropic Votes positifs
wav2vec 2.0 Votes positifs
Claude 3 \ Anthropic Fonctionnalités principales
Trois niveaux de modèles (Haiku, Sonnet, Opus) vous permettent de choisir le bon équilibre entre vitesse, coût et profondeur de raisonnement
Fenêtre de contexte de 200K tokens au lancement, avec plus de 1M de tokens en entrée disponibles pour les clients entreprise
Prise en charge de la vision pour les photos, graphiques, diagrammes, PDFs et schémas techniques
Haiku lit un article de recherche d'environ 10k tokens avec graphiques en moins de trois secondes pour les charges de travail en chat en direct
Disponible sur claude.ai, l'API Claude, Amazon Bedrock et Google Cloud Vertex AI
wav2vec 2.0 Fonctionnalités principales
Le pré-entraînement auto-supervisé sur audio brut 🎧 permet d'apprendre à partir de données vocales non étiquetées
Le masquage de l'espace latent 🎭 améliore la concentration du modèle sur le contexte et sa robustesse
La tâche contrastive sur des représentations quantifiées 🔄 aide à apprendre des unités vocales discrètes
Le fine-tuning avec un minimum de données étiquetées 📝 atteint une forte précision en reconnaissance vocale
L'architecture basée sur un Transformer 🔗 capture efficacement les dépendances à longue portée du discours
Claude 3 \ Anthropic Catégorie
- Large Language Model (LLM)
wav2vec 2.0 Catégorie
- Large Language Model (LLM)
Claude 3 \ Anthropic Type de tarification
- Freemium
wav2vec 2.0 Type de tarification
- Freemium