OneOver vs wav2vec 2.0
Dans le concours de OneOver vs wav2vec 2.0, quel outil AI Large Language Model (LLM) est le champion? Nous évaluons les prix, les alternatives, les votes positifs, les fonctionnalités, les avis, et plus encore.
Si vous deviez choisir entre OneOver et wav2vec 2.0, lequel préféreriez-vous?
Lorsque nous examinons OneOver et wav2vec 2.0, tous deux étant des outils large language model (llm) alimentés par l'IA, quelles caractéristiques uniques découvrons-nous ? Il n'y a pas de vainqueur clair en termes de votes positifs, car les deux outils ont reçu le même nombre. Rejoignez les utilisateurs de aitools.fyi pour décider du gagnant en votant.
Vous n'êtes pas d'accord avec le résultat? Votez pour nous aider à décider!
OneOver
Qu'est-ce que OneOver?
OneOver est un studio créatif qui regroupe chat multi-modèles, génération d'images, vidéo, voix et musique dans un seul espace de travail navigateur. Vous pouvez utiliser GPT, Claude, Gemini, Grok et des dizaines d'autres modèles dans un seul fil de discussion, joindre des PDF et des images, activer la recherche web et changer de modèle sans perdre le contexte. Les invités disposent de cinq messages de chat avant inscription, et les nouveaux comptes reçoivent 50 crédits de démarrage uniques.
Alors que la plupart des outils vous obligent à choisir un fournisseur et à acheter des abonnements séparés pour les images ou la vidéo, OneOver fait transiter tout via un solde de crédits partagé. Les recharges d'abonnement, les bonus de forfait et les packs à la consommation s'utilisent sur le chat, la diffusion, la vidéo, la parole, la musique et les mini applications playground. Passer de GPT-5.4 Nano à Claude Opus 5 se fait par un menu déroulant dans la même conversation, sans copier-coller entre sites.
Créateurs et marketeurs utilisent OneOver pour rédiger des textes, itérer des visuels et transformer des prompts ou photos en clips courts depuis une seule bibliothèque. Les développeurs peuvent accéder aux mêmes modèles via une API REST avec support du streaming. Pro et Studio proposent aussi des plans d'équipe basés sur le nombre de sièges, mutualisant les crédits mensuels avec des limites souples par membre et une facture unique.
wav2vec 2.0
Qu'est-ce que wav2vec 2.0?
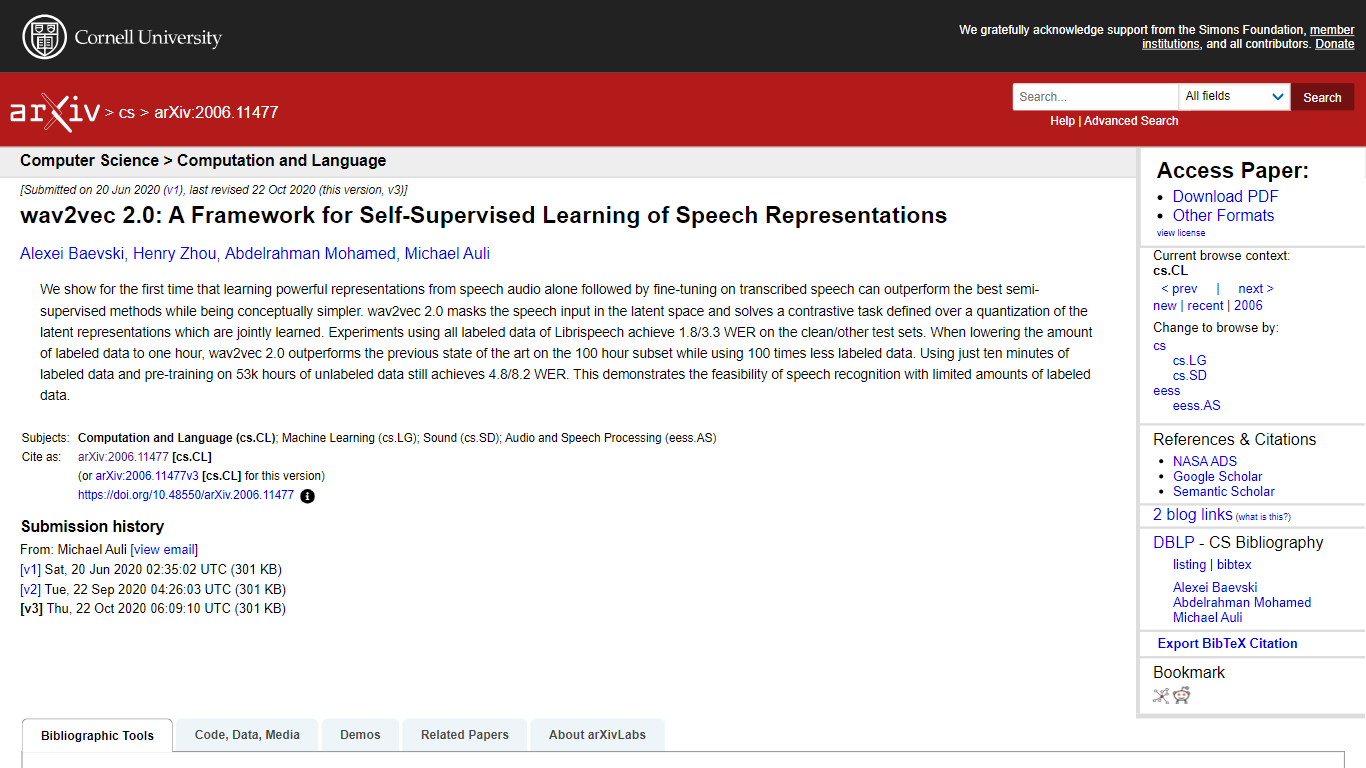
wav2vec 2.0 est un cadre d'apprentissage auto-supervisé qui apprend des représentations de la parole directement à partir de l'audio brut. Il masque des portions de l'entrée audio dans un espace latent et résout une tâche contrastive sur des représentations latentes quantifiées, qui sont apprises conjointement avec le modèle. Cette approche permet au modèle de tirer parti efficacement de grandes quantités de données audio non étiquetées. Après pré-entraînement, wav2vec 2.0 peut être affiné sur de petites quantités de données audio étiquetées pour atteindre des performances de reconnaissance vocale à la pointe de la technologie. Le modèle a démontré de bons résultats même lorsqu'il est affiné avec seulement quelques minutes d'audio étiqueté, ce qui le rend très efficace pour les scénarios à faibles ressources.
Le cadre simplifie la reconnaissance vocale en supprimant la nécessité de pipelines semi-supervisés complexes, en s'appuyant plutôt sur un seul modèle de bout en bout. Il atteint des taux d'erreur word impressionnants sur des benchmarks standard comme Librispeech et TIMIT, surpassant les méthodes précédentes qui nécessitent beaucoup plus de données étiquetées. La quantification des représentations de la parole latentes permet au modèle d'apprendre des unités de parole discrètes, ce qui améliore la robustesse et la généralisation.
wav2vec 2.0 cible les chercheurs et les développeurs travaillant sur la reconnaissance vocale, en particulier ceux qui souhaitent exploiter des données audio non étiquetées pour réduire les coûts d'annotation. Sa capacité à bien fonctionner avec peu de données étiquetées ouvre des opportunités pour construire des systèmes de reconnaissance dans des langues ou des domaines à faibles ressources. L'architecture du modèle repose sur des encodeurs de caractéristiques convolutifs et des réseaux Transformer, lui permettant de capturer à la fois les motifs locaux et globaux de la parole.
Techniquement, wav2vec 2.0 combine l'apprentissage contrastif avec une stratégie de masquage appliquée dans l'espace latent, ce qui diffère des approches précédentes qui masquent directement l'audio d'entrée. Ce choix de conception améliore la qualité des représentations apprises. Le modèle est entraîné sur de grands ensembles de données non étiquetées, comme 53 000 heures de parole, puis affiné sur des sous-ensembles plus petits avec étiquettes. Ce processus d'entraînement en deux étapes équilibre évolutivité et précision.
Dans l'ensemble, wav2vec 2.0 représente une avancée majeure dans l'apprentissage de représentations de la parole auto-supervisé. Il réduit la dépendance aux données étiquetées, simplifie les pipelines d'entraînement et atteint des performances comparables ou supérieures à celles des méthodes entièrement supervisées ou semi-supervisées. La sortie du code et des modèles pré-entraînés facilite son adoption et la recherche future en technologie vocale.
OneOver Votes positifs
wav2vec 2.0 Votes positifs
OneOver Fonctionnalités principales
Passer de GPT-5.6 Sol, Claude Opus 5, Gemini 3.6 Flash et Grok 4.6 dans un même fil sans perdre le contexte
Pro inclut 1 400 crédits par mois (1 000 de base plus 400 bonus) pour chat, images et vidéos courtes
Générateurs de texte en parole et musique côte à côte avec studios d'images et vidéos dans le même pool de crédits
Les packs à paiement à l'usage commencent à 5 $ pour 500 crédits qui n'expirent jamais et s'empilent avec les soldes d'abonnement
L'API REST couvre le chat, la génération d'images et la facturation d'utilisation avec streaming et échanges de modèles à un champ
Dix mini-apps de playground incluent Générateur de mèmes, Améliorateur, et Assistant devoirs avec des coûts à partir de 1 crédit
wav2vec 2.0 Fonctionnalités principales
Le pré-entraînement auto-supervisé sur audio brut 🎧 permet d'apprendre à partir de données vocales non étiquetées
Le masquage de l'espace latent 🎭 améliore la concentration du modèle sur le contexte et sa robustesse
La tâche contrastive sur des représentations quantifiées 🔄 aide à apprendre des unités vocales discrètes
Le fine-tuning avec un minimum de données étiquetées 📝 atteint une forte précision en reconnaissance vocale
L'architecture basée sur un Transformer 🔗 capture efficacement les dépendances à longue portée du discours
OneOver Catégorie
- Large Language Model (LLM)
wav2vec 2.0 Catégorie
- Large Language Model (LLM)
OneOver Type de tarification
- Freemium
wav2vec 2.0 Type de tarification
- Freemium