Voice to Text vs Deep Voice 3
Explorez le face-à-face entre Voice to Text vs Deep Voice 3 et découvrez quel outil AI Text to Speech (TTS) gagne. Nous analysons les votes positifs, les fonctionnalités, les avis, les prix, les alternatives, et plus encore.
Dans un face-à-face entre Voice to Text et Deep Voice 3, lequel prend la couronne?
Quand nous contrastons Voice to Text avec Deep Voice 3, tous deux étant des outils exceptionnels text to speech (tts) opérés par l'IA, et les plaçons côte à côte, nous pouvons repérer plusieurs similitudes et divergences cruciales. Il n'y a pas de vainqueur clair en termes de votes positifs, car les deux outils ont reçu le même nombre. Le pouvoir est entre vos mains ! Votez et participez à la décision du gagnant.
Vous n'êtes pas d'accord avec le résultat? Votez pour votre outil préféré et aidez-le à gagner!
Voice to Text
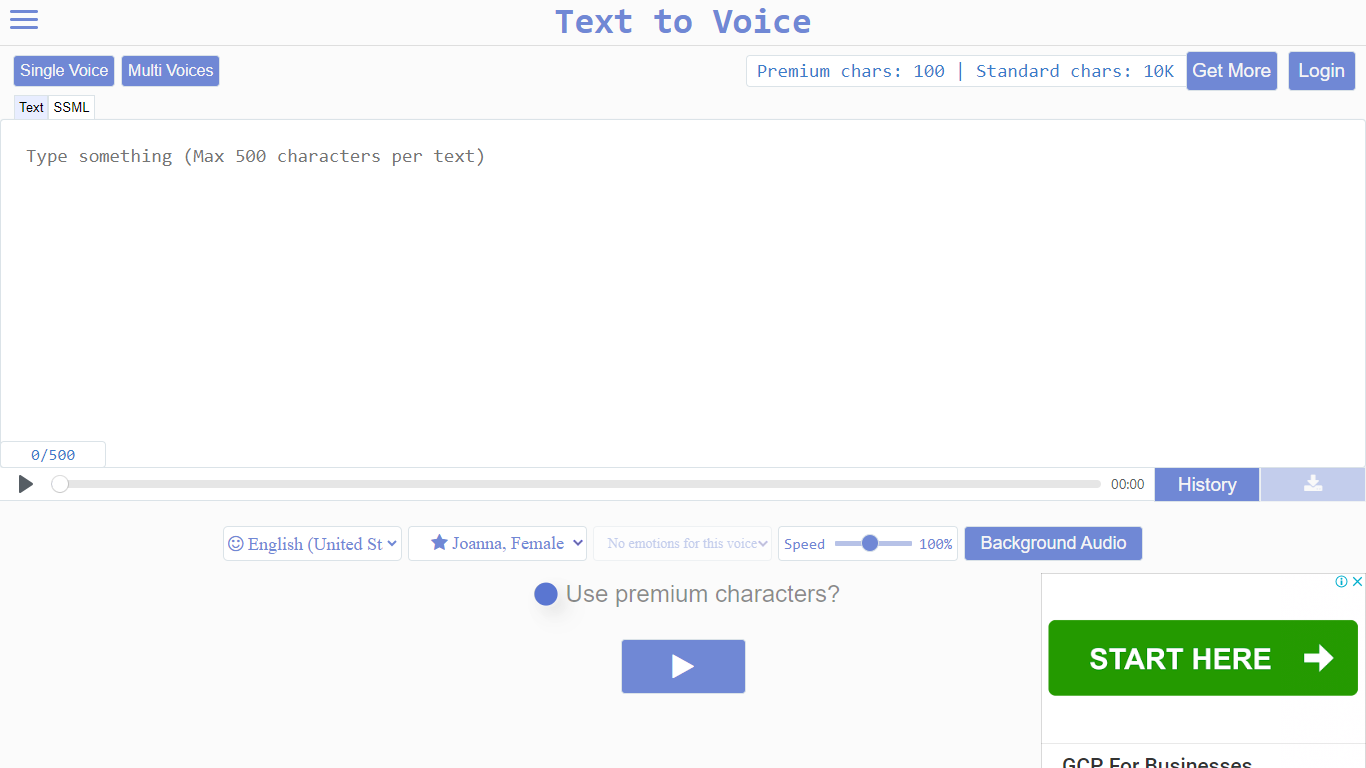

Qu'est-ce que Voice to Text?
Text to Voice (texttovoice.online) est une plateforme de synthèse vocale en ligne qui transforme le texte écrit en fichiers MP3 de voix off téléchargeables. Vous tapez ou collez du texte, choisissez une langue et une voix, ajustez la vitesse et l'émotion, puis écoutez ou téléchargez le résultat. Aucune installation sur bureau n'est nécessaire ; cela fonctionne dans le navigateur sur Mac, Windows et mobile.
Le convertisseur principal prend en charge un grand catalogue de langues et d'accents régionaux, avec des outils séparés pour les voix standard, voix Gen2, voix à la demande, scripts multi-interprètes, modification de voix, clonage de voix et effets sonores. Les voix Gen2 visent à produire un rendu plus naturel avec une émotion inférée du contexte du texte. Les voix premium utilisent un algorithme plus avancé pour un discours moins robotique, tandis que les voix standard couvrent un usage quotidien avec une allocation de caractères gratuite.
Les comptes gratuits sont réinitialisés quotidiennement avec des pools de caractères premium et standard. Les plans payants offrent des limites plus élevées, un usage commercial, des sons d'ambiance, un historique des fichiers, des effets sonores et un accès API pour le niveau supérieur. La connexion via Google est également supportée, ainsi que l'inscription par email.
Deep Voice 3
Qu'est-ce que Deep Voice 3?
Deep Voice 3 est une implémentation open-source de PyTorch du modèle de synthèse vocale Deep Voice 3 de Baidu Research. Il reproduit l'apprentissage par séquence convolutionnelle pour une synthèse vocale neuronale évolutive et fournit des points de contrôle pré-entraînés avec des démonstrations audio pour les configurations mono-voix et multi-voix.
Le projet inclut des modèles entraînés sur LJSpeech pour la synthèse mono-voix et sur VCTK pour la génération multi-voix à 108 locuteurs. La page de démonstration héberge des extraits audio, des graphiques d'attention et des liens vers les poids pré-entraînés sur GitHub.
Il s'adresse aux chercheurs et développeurs qui souhaitent une implémentation de référence de Deep Voice 3 plutôt qu'une API vocale hébergée. Les scripts d'entraînement, le code d'inférence et les contributions communautaires sont disponibles dans le référentiel GitHub public.
Voice to Text Votes positifs
Deep Voice 3 Votes positifs
Voice to Text Fonctionnalités principales
Convertissez le texte en parole dans des dizaines de langues avec des contrôles de genre, d'accent et d'émotion
Les voix Gen2 produisent un son plus réaliste avec des émotions contextuelles et des variations de ton à la lecture
Le mode multi-intervenants crée des scripts avec différentes voix, vitesses et pauses par ligne
Le changeur de voix transforme l'audio téléchargé en une autre voix tout en conservant l'émotion d'origine
Clonez une voix Gen2 à partir d'un échantillon clair de plus de 10 secondes (plan Pro ; les clones expirent après 30 jours)
Téléchargez les voix off terminées au format MP3 en un clic avec le forfait gratuit
Deep Voice 3 Fonctionnalités principales
Implémentation PyTorch de Deep Voice 3, synthèse vocale séquentielle convolutionnelle
Modèle mono-locuteur pré-entraîné sur LJSpeech avec échantillons audio publics
Modèle multi-locuteurs VCTK supportant 108 locuteurs avec extraits de démonstration
Code open-source et checkpoints pré-entraînés sur GitHub
Page de démonstration avec visualisations d'attention et liens vers les articles de référence
Voice to Text Catégorie
- Text to Speech (TTS)
Deep Voice 3 Catégorie
- Text to Speech (TTS)
Voice to Text Type de tarification
- Freemium
Deep Voice 3 Type de tarification
- Free