Claude 3 \ Anthropic vs wav2vec 2.0
Compare Claude 3 \ Anthropic vs wav2vec 2.0 e veja qual ferramenta AI Large Language Model (LLM) é melhor quando comparamos recursos, avaliações, preços, alternativas, votos positivos, etc.
Qual é melhor? Claude 3 \ Anthropic ou wav2vec 2.0?
Quando comparamos Claude 3 \ Anthropic com wav2vec 2.0, ambas ferramentas são alimentadas por inteligência artificial na categoria de large language model (llm), Na corrida pelos votos positivos, Claude 3 \ Anthropic leva o troféu. Claude 3 \ Anthropic atraiu 8 votos positivos dos usuários da aitools.fyi, e wav2vec 2.0 atraiu 6 votos positivos.
Você não concorda com o resultado? Vote para nos ajudar a decidir!
Claude 3 \ Anthropic
O que é Claude 3 \ Anthropic?
Claude 3 é a família de modelos de linguagem de terceira geração da Anthropic, lançada em março de 2024. Ela inclui três diferentes níveis: Haiku, para velocidade e custo; Sonnet, para desempenho equilibrado; e Opus, para a maior profundidade de raciocínio. Cada modelo tem como foco um compromisso diferente entre inteligência, latência e preço.
A família lida com tarefas de texto, código, análise e visão. Os modelos Claude 3 processam fotos, gráficos, diagramas técnicos e tabelas. No lançamento, suportam uma janela de contexto de 200 mil tokens, com entradas que ultrapassam 1 milhão de tokens disponíveis para clientes selecionados. Opus e Sonnet foram lançados na claude.ai e na API Claude em 159 países, seguidos logo após pelo Haiku.
A Anthropic construiu o Claude 3 usando métodos de segurança de IA Constitucional e diretrizes de Responsible Scaling Policy. Os modelos estão disponíveis através da API Claude, Amazon Bedrock e Google Cloud Vertex AI. Sonnet alimenta o nível gratuito em claude.ai, enquanto Opus está disponível para assinantes do Claude Pro.
wav2vec 2.0
O que é wav2vec 2.0?
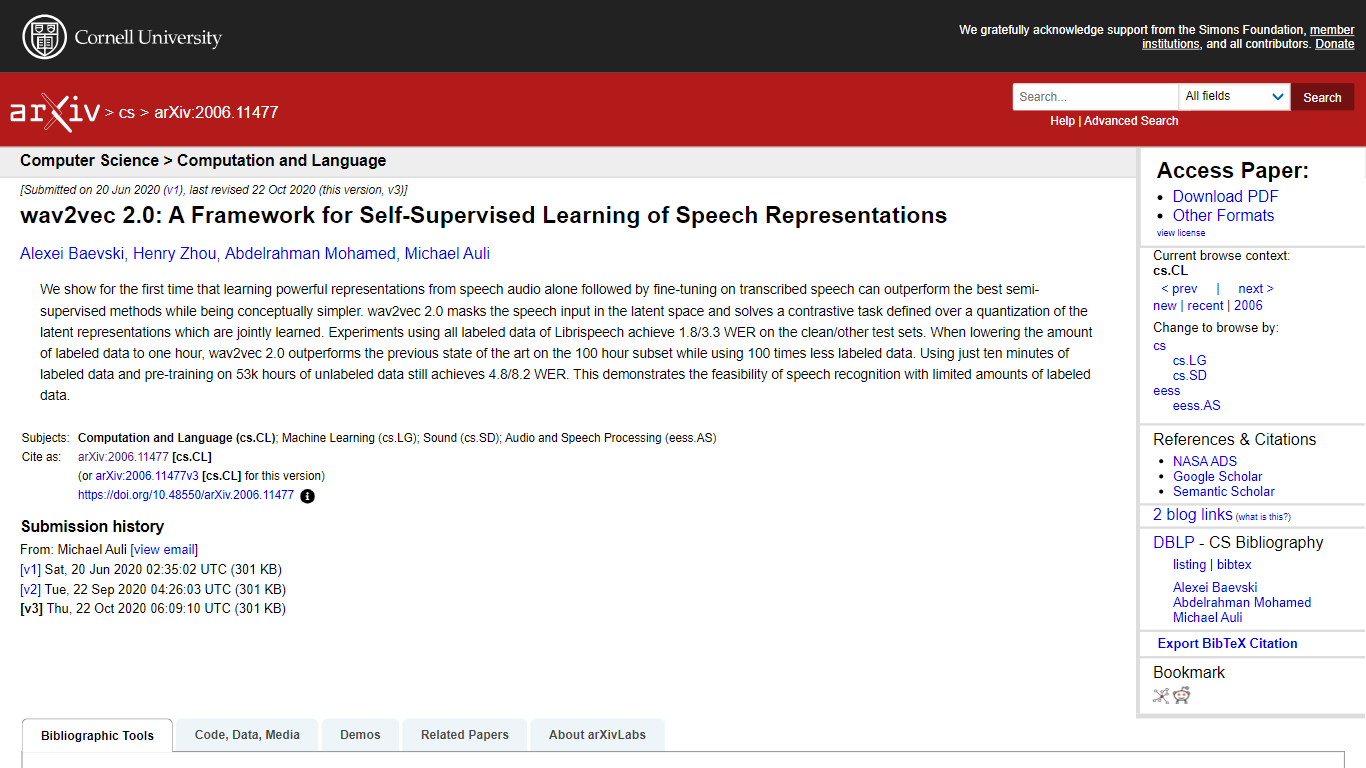
wav2vec 2.0 é uma estrutura de aprendizado auto-supervisionado que aprende representações de fala diretamente de áudio bruto. Ela mascara partes da entrada de fala em um espaço latente e resolve uma tarefa contrastiva sobre representações latentes quantizadas, que são aprendidas conjuntamente com o modelo. Essa abordagem permite que o modelo aproveite grandes quantidades de dados de fala não rotulados de forma eficaz. Após o pré-treinamento, wav2vec 2.0 pode ser ajustado com pequenas quantidades de dados de fala rotulados para alcançar um desempenho de reconhecimento de fala de ponta. O modelo demonstrou resultados fortes mesmo quando ajustado com apenas minutos de áudio rotulado, tornando-se altamente eficiente para cenários de poucos recursos.
A estrutura simplifica o reconhecimento de fala ao remover a necessidade de pipelines semi-supervisionados complexos, apoiando-se em um único modelo de ponta a ponta. Ele alcança taxas de erro de palavra impressionantes em benchmarks padrão como Librispeech e TIMIT, superando métodos anteriores que requerem muito mais dados rotulados. A quantização das representações de fala latentes permite que o modelo aprenda unidades de fala discretas, o que melhora a robustez e a generalização.
wav2vec 2.0 é direcionado a pesquisadores e desenvolvedores que trabalham com reconhecimento de fala, especialmente aqueles interessados em aproveitar dados de áudio não rotulados para reduzir custos de anotação. Sua capacidade de performar bem com dados rotulados limitados abre oportunidades para construir sistemas de fala em línguas ou domínios de recursos baixos. Sua arquitetura é baseada em codificadores de características convolucionais e redes Transformer, permitindo capturar padrões de fala tanto locais quanto globais.
Tecnicamente, wav2vec 2.0 combina aprendizado contrastivo com uma estratégia de máscara aplicada no espaço latente, o que difere de abordagens anteriores que mascaram o áudio de entrada diretamente. Essa escolha de design melhora a qualidade das representações aprendidas. O modelo é treinado em grandes conjuntos de dados não rotulados, como 53.000 horas de fala, e ajustado em subconjuntos menores rotulados. Esse processo de treinamento em duas etapas equilibra escalabilidade e precisão.
No geral, wav2vec 2.0 representa um avanço significativo no aprendizado de representações de fala auto-supervisionado. Ele reduz a dependência de dados rotulados, simplifica as pipelines de treinamento e alcança desempenho competitivo ou superior em relação a métodos totalmente supervisionados ou semi-supervisionados. O lançamento do código e dos modelos pré-treinados apoia a adoção e pesquisas adicionais em tecnologia de fala.
Claude 3 \ Anthropic Votos positivos
wav2vec 2.0 Votos positivos
Claude 3 \ Anthropic Recursos principais
Três níveis de modelo (Haiku, Sonnet, Opus) permitem escolher o equilíbrio certo entre velocidade, custo e profundidade de raciocínio
Janela de contexto de 200K tokens no lançamento, com entradas de mais de 1M de tokens disponíveis para clientes empresariais
Suporte à visão para fotos, gráficos, diagramas, PDFs e diagramas técnicos
Haiku lê um artigo de pesquisa de cerca de 10 mil tokens com gráficos em menos de três segundos para cargas de trabalho de chat ao vivo
Disponível em claude.ai, na API Claude, Amazon Bedrock e Google Cloud Vertex AI
wav2vec 2.0 Recursos principais
Pré-treinamento auto-supervisionado em áudio bruto 🎧 permite aprender a partir de dados de fala não rotulados
Mascaramento no espaço latente 🎭 melhora o foco do modelo no contexto e a robustez
Tarefa contrastiva sobre representações quantizadas 🔄 ajuda a aprender unidades discretas de fala
Ajuste fino com dados rotulados mínimos 📝 alcança alta precisão no reconhecimento de fala
Arquitetura baseada em Transformer 🔗 captura efetivamente dependências de fala em longo alcance
Claude 3 \ Anthropic Categoria
- Large Language Model (LLM)
wav2vec 2.0 Categoria
- Large Language Model (LLM)
Claude 3 \ Anthropic Tipo de tarifação
- Freemium
wav2vec 2.0 Tipo de tarifação
- Freemium