Última atualização 07-26-2026
Categoria:
Reviews:
Junte-se a milhares de entusiastas de IA no Mundo da IA!
wav2vec 2.0
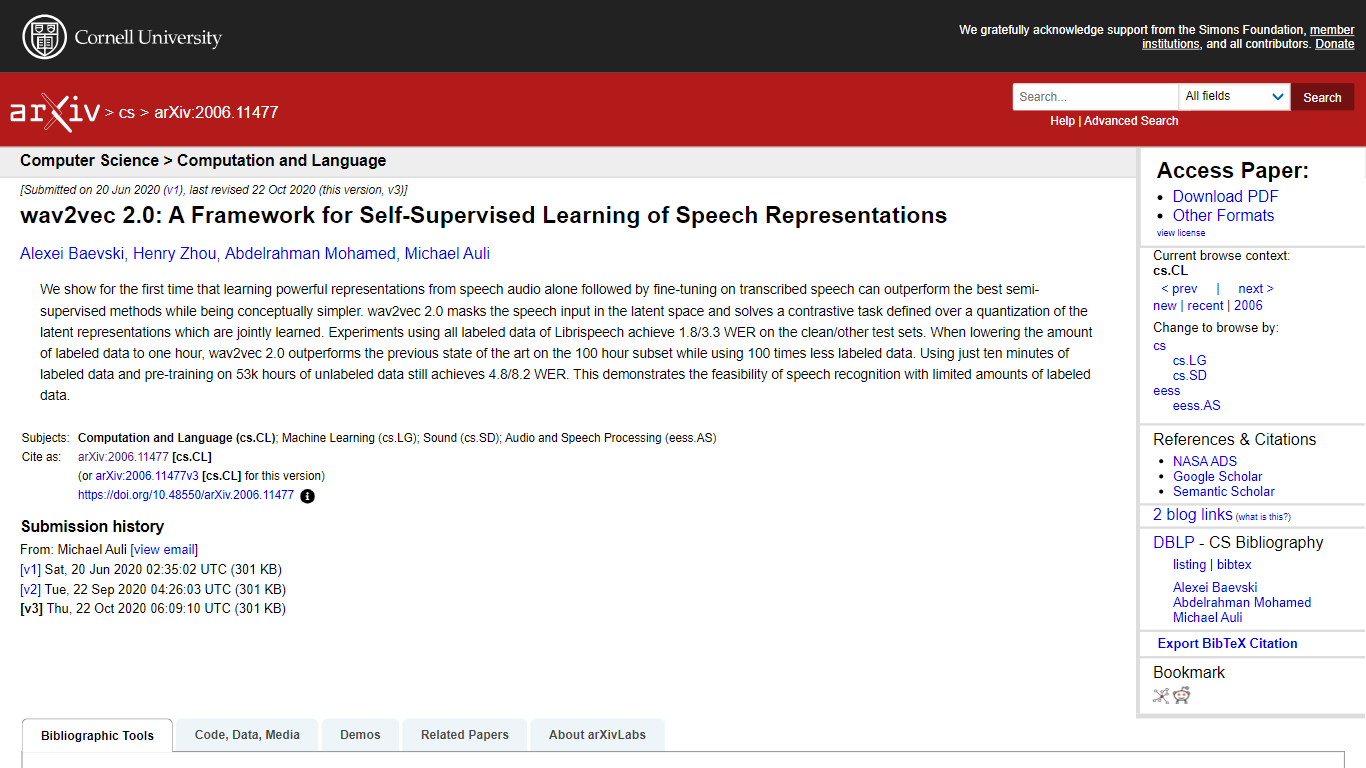
wav2vec 2.0 é uma estrutura de aprendizado auto-supervisionado que aprende representações de fala diretamente de áudio bruto. Ela mascara partes da entrada de fala em um espaço latente e resolve uma tarefa contrastiva sobre representações latentes quantizadas, que são aprendidas conjuntamente com o modelo. Essa abordagem permite que o modelo aproveite grandes quantidades de dados de fala não rotulados de forma eficaz. Após o pré-treinamento, wav2vec 2.0 pode ser ajustado com pequenas quantidades de dados de fala rotulados para alcançar um desempenho de reconhecimento de fala de ponta. O modelo demonstrou resultados fortes mesmo quando ajustado com apenas minutos de áudio rotulado, tornando-se altamente eficiente para cenários de poucos recursos.
A estrutura simplifica o reconhecimento de fala ao remover a necessidade de pipelines semi-supervisionados complexos, apoiando-se em um único modelo de ponta a ponta. Ele alcança taxas de erro de palavra impressionantes em benchmarks padrão como Librispeech e TIMIT, superando métodos anteriores que requerem muito mais dados rotulados. A quantização das representações de fala latentes permite que o modelo aprenda unidades de fala discretas, o que melhora a robustez e a generalização.
wav2vec 2.0 é direcionado a pesquisadores e desenvolvedores que trabalham com reconhecimento de fala, especialmente aqueles interessados em aproveitar dados de áudio não rotulados para reduzir custos de anotação. Sua capacidade de performar bem com dados rotulados limitados abre oportunidades para construir sistemas de fala em línguas ou domínios de recursos baixos. Sua arquitetura é baseada em codificadores de características convolucionais e redes Transformer, permitindo capturar padrões de fala tanto locais quanto globais.
Tecnicamente, wav2vec 2.0 combina aprendizado contrastivo com uma estratégia de máscara aplicada no espaço latente, o que difere de abordagens anteriores que mascaram o áudio de entrada diretamente. Essa escolha de design melhora a qualidade das representações aprendidas. O modelo é treinado em grandes conjuntos de dados não rotulados, como 53.000 horas de fala, e ajustado em subconjuntos menores rotulados. Esse processo de treinamento em duas etapas equilibra escalabilidade e precisão.
No geral, wav2vec 2.0 representa um avanço significativo no aprendizado de representações de fala auto-supervisionado. Ele reduz a dependência de dados rotulados, simplifica as pipelines de treinamento e alcança desempenho competitivo ou superior em relação a métodos totalmente supervisionados ou semi-supervisionados. O lançamento do código e dos modelos pré-treinados apoia a adoção e pesquisas adicionais em tecnologia de fala.
Pré-treinamento auto-supervisionado em áudio bruto 🎧 permite aprender a partir de dados de fala não rotulados
Mascaramento no espaço latente 🎭 melhora o foco do modelo no contexto e a robustez
Tarefa contrastiva sobre representações quantizadas 🔄 ajuda a aprender unidades discretas de fala
Ajuste fino com dados rotulados mínimos 📝 alcança alta precisão no reconhecimento de fala
Arquitetura baseada em Transformer 🔗 captura efetivamente dependências de fala em longo alcance
Alcança reconhecimento de voz de última geração com dados rotulados limitados
Simplifica o treinamento combinando pré-treinamento e fine-tuning em um único modelo
Suporta idiomas e domínios com poucos recursos aproveitando áudio não rotulado
Código open-source e modelos pré-treinados disponíveis para adoção fácil
Robusto a condições de fala ruidosas e diversas devido à máscara latente
Requer grandes volumes de dados de fala não rotulados para pré-treinamento eficaz
Treinamento computacionalmente intensivo devido à arquitetura Transformer
O ajuste fino ainda necessita de alguns dados rotulados para melhor desempenho
Como o wav2vec 2.0 aprende com dados de fala não rotulados?
Ele usa aprendizado auto-supervisionado mascarando partes da representação latente da fala e resolvendo uma tarefa contrastiva para prever o latente quantizado correto entre distratores.
O wav2vec 2.0 pode funcionar com muito poucos dados rotulados?
Sim, ele alcança resultados fortes em reconhecimento de fala mesmo quando ajustado com apenas dez minutos de áudio rotulado.
O que torna o wav2vec 2.0 diferente dos modelos de fala anteriores?
Ele mascara a fala no espaço latente e aprende representações quantizadas de forma conjunta, simplificando o treinamento e melhorando o desempenho em relação a métodos semi-supervisionados.
Quais arquiteturas o wav2vec 2.0 usa?
Ele combina codificadores convolucionais de características com redes Transformer para capturar características locais e globais da fala.
O wav2vec 2.0 é adequado para ambientes de fala com ruído?
Sim, sua mascaramento latente e aprendizado contrastivo melhoram a robustez ao ruído e a diversas condições de fala.
Modelos pré-treinados e código estão disponíveis?
Sim, os autores liberaram código e modelos pré-treinados para facilitar pesquisa e desenvolvimento.
Quais conjuntos de dados foram usados para treinar o wav2vec 2.0?
Ele foi pré-treinado em grandes conjuntos de dados não rotulados, como 53.000 horas de fala, e ajustado em subconjuntos rotulados como Librispeech.