wav2vec 2.0 vs ggml.ai
Ao comparar wav2vec 2.0 vs ggml.ai, qual ferramenta AI Large Language Model (LLM) brilha mais? Analisamos preços, alternativas, votos positivos, recursos, avaliações e muito mais.
Em uma comparação entre wav2vec 2.0 e ggml.ai, qual sai por cima?
Quando colocamos wav2vec 2.0 e ggml.ai um ao lado do outro, ambas sendo ferramentas alimentadas por inteligência artificial na categoria de large language model (llm), A comunidade falou, ggml.ai lidera com mais votos positivos. ggml.ai foi votado positivamente 7 vezes pelos usuários da aitools.fyi, e wav2vec 2.0 foi votado positivamente 6 vezes.
O resultado faz você dizer "hmm"? Vote e transforme essa carranca em um sorriso!
wav2vec 2.0
O que é wav2vec 2.0?
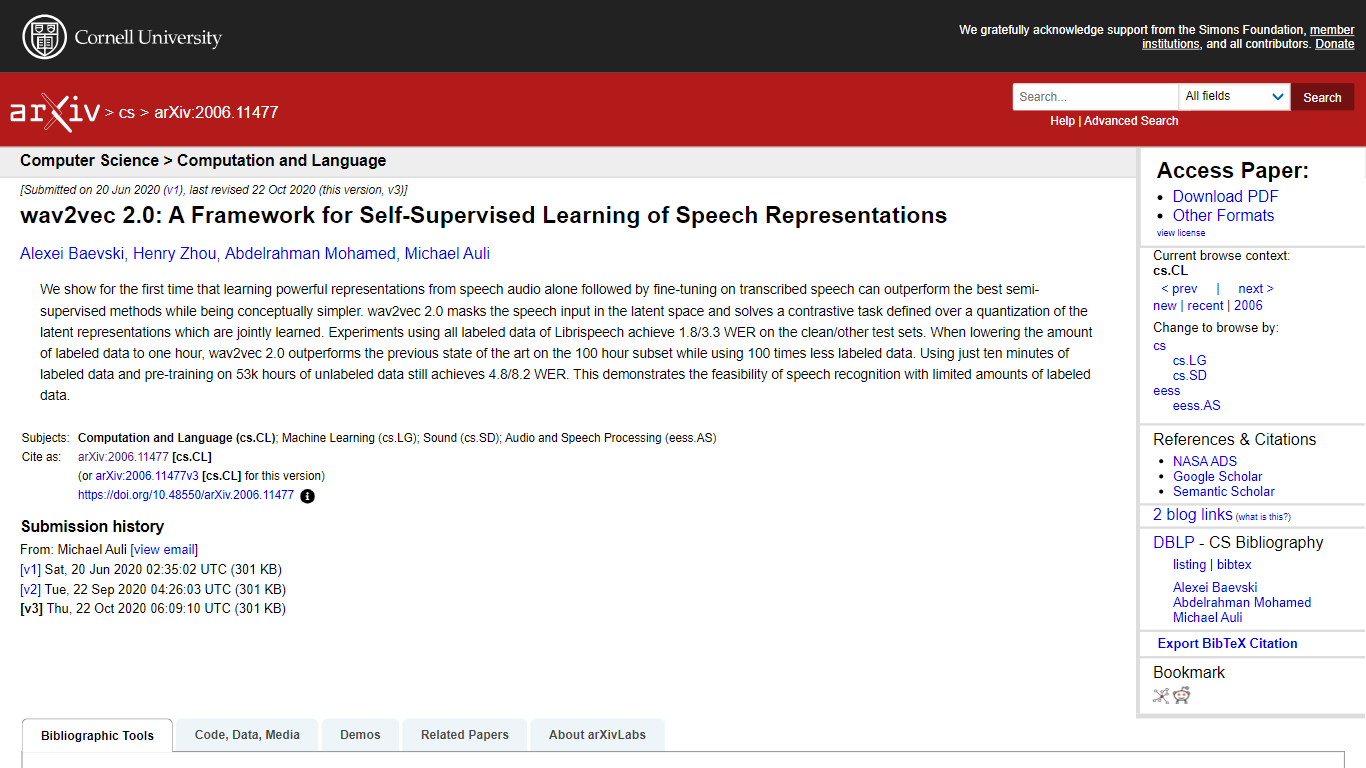
wav2vec 2.0 é uma estrutura de aprendizado auto-supervisionado que aprende representações de fala diretamente de áudio bruto. Ela mascara partes da entrada de fala em um espaço latente e resolve uma tarefa contrastiva sobre representações latentes quantizadas, que são aprendidas conjuntamente com o modelo. Essa abordagem permite que o modelo aproveite grandes quantidades de dados de fala não rotulados de forma eficaz. Após o pré-treinamento, wav2vec 2.0 pode ser ajustado com pequenas quantidades de dados de fala rotulados para alcançar um desempenho de reconhecimento de fala de ponta. O modelo demonstrou resultados fortes mesmo quando ajustado com apenas minutos de áudio rotulado, tornando-se altamente eficiente para cenários de poucos recursos.
A estrutura simplifica o reconhecimento de fala ao remover a necessidade de pipelines semi-supervisionados complexos, apoiando-se em um único modelo de ponta a ponta. Ele alcança taxas de erro de palavra impressionantes em benchmarks padrão como Librispeech e TIMIT, superando métodos anteriores que requerem muito mais dados rotulados. A quantização das representações de fala latentes permite que o modelo aprenda unidades de fala discretas, o que melhora a robustez e a generalização.
wav2vec 2.0 é direcionado a pesquisadores e desenvolvedores que trabalham com reconhecimento de fala, especialmente aqueles interessados em aproveitar dados de áudio não rotulados para reduzir custos de anotação. Sua capacidade de performar bem com dados rotulados limitados abre oportunidades para construir sistemas de fala em línguas ou domínios de recursos baixos. Sua arquitetura é baseada em codificadores de características convolucionais e redes Transformer, permitindo capturar padrões de fala tanto locais quanto globais.
Tecnicamente, wav2vec 2.0 combina aprendizado contrastivo com uma estratégia de máscara aplicada no espaço latente, o que difere de abordagens anteriores que mascaram o áudio de entrada diretamente. Essa escolha de design melhora a qualidade das representações aprendidas. O modelo é treinado em grandes conjuntos de dados não rotulados, como 53.000 horas de fala, e ajustado em subconjuntos menores rotulados. Esse processo de treinamento em duas etapas equilibra escalabilidade e precisão.
No geral, wav2vec 2.0 representa um avanço significativo no aprendizado de representações de fala auto-supervisionado. Ele reduz a dependência de dados rotulados, simplifica as pipelines de treinamento e alcança desempenho competitivo ou superior em relação a métodos totalmente supervisionados ou semi-supervisionados. O lançamento do código e dos modelos pré-treinados apoia a adoção e pesquisas adicionais em tecnologia de fala.
ggml.ai
O que é ggml.ai?
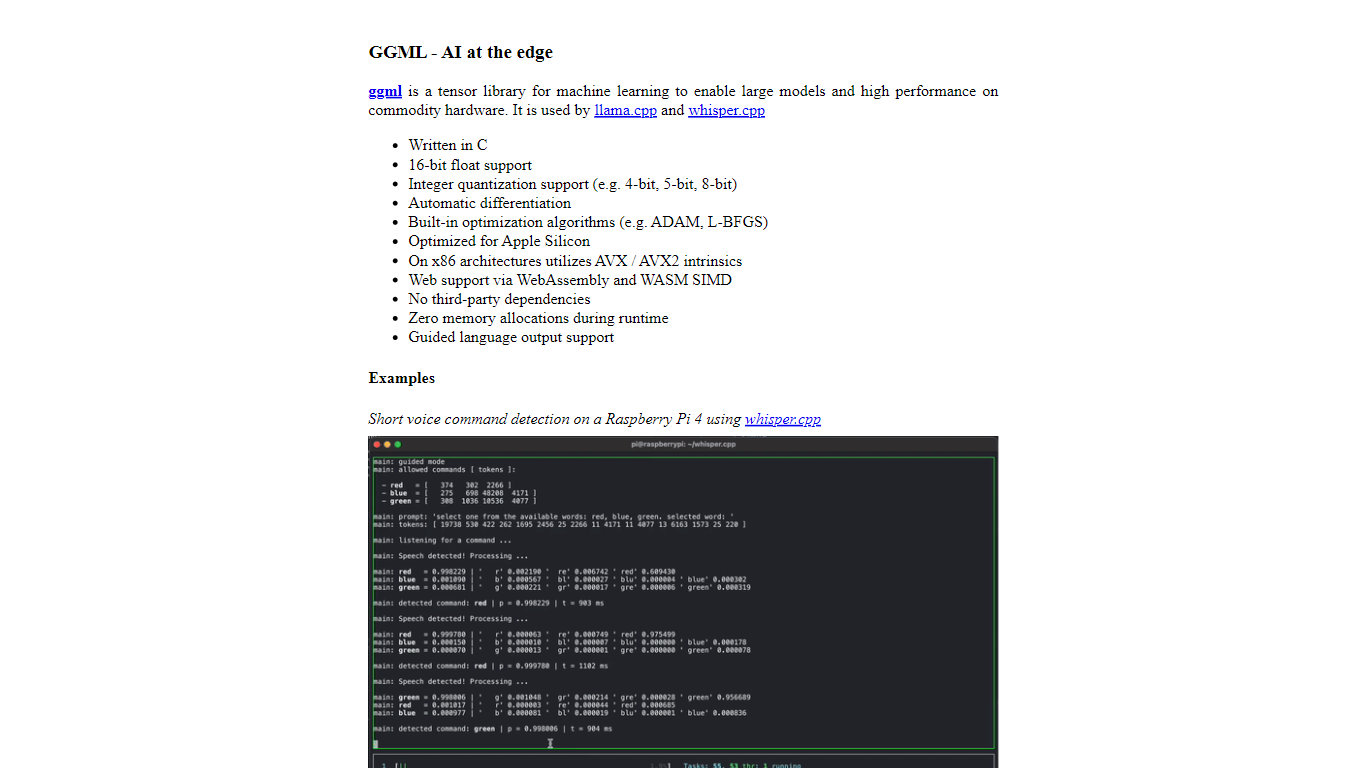
ggml executa modelos grandes de linguagem e fala em CPUs e GPUs comuns por meio de uma biblioteca compacta de tensores em C, construída para inferência no dispositivo. Engenheiros de ML e desenvolvedores de aplicativos a adotam via llama.cpp e whisper.cpp quando desejam cargas de trabalho LLaMA ou Whisper sem dependências exclusivas de nuvem.
Frameworks como PyTorch são otimizados para clusters de treinamento e tempos de execução pesados. ggml mantém a biblioteca principal minimalista, sem alocações de memória em tempo de execução, sem dependências de terceiros e com quantização inteira para que o llama.cpp possa servir pesos Meta LLaMA em laptops e Apple Silicon.
A empresa ggml.ai foi fundada em 2023 por Georgi Gerganov para dar suporte à biblioteca e foi adquirida pela Hugging Face em 2026. O projeto principal ggml permanece licenciado sob MIT com desenvolvimento aberto no GitHub.
wav2vec 2.0 Votos positivos
ggml.ai Votos positivos
wav2vec 2.0 Recursos principais
Pré-treinamento auto-supervisionado em áudio bruto 🎧 permite aprender a partir de dados de fala não rotulados
Mascaramento no espaço latente 🎭 melhora o foco do modelo no contexto e a robustez
Tarefa contrastiva sobre representações quantizadas 🔄 ajuda a aprender unidades discretas de fala
Ajuste fino com dados rotulados mínimos 📝 alcança alta precisão no reconhecimento de fala
Arquitetura baseada em Transformer 🔗 captura efetivamente dependências de fala em longo alcance
ggml.ai Recursos principais
Potencializa llama.cpp para inferência Meta LLaMA e whisper.cpp para modelos de fala OpenAI Whisper
Escrito em C com zero alocações de memória em tempo de execução durante a inferência
Suporte à quantização de inteiros para modelos menores em hardware comum
Sem dependências de terceiros na biblioteca de tensores principal
Implementação de baixo nível multiplataforma com amplo suporte de hardware
Biblioteca open-core licenciada sob MIT com desenvolvimento público no GitHub
wav2vec 2.0 Categoria
- Large Language Model (LLM)
ggml.ai Categoria
- Large Language Model (LLM)
wav2vec 2.0 Tipo de tarifação
- Freemium
ggml.ai Tipo de tarifação
- Free