Cognee vs wav2vec 2.0
Dans le choc de Cognee vs wav2vec 2.0, quel outil AI Large Language Model (LLM) émerge victorieux? Nous évaluons les avis, les prix, les alternatives, les fonctionnalités, les votes positifs, et plus encore.
Quand nous mettons Cognee et wav2vec 2.0 côte à côte, lequel émerge comme le vainqueur?
Prenons un plus près regard sur Cognee et wav2vec 2.0, tous deux étant des outils large language model (llm) alimentés par l'IA, et voyons ce qui les distingue. Les deux outils sont également favorisés, comme l'indique le décompte identique des votes positifs. Chaque vote compte ! Faites le vôtre et contribuez à la décision du gagnant.
Vous n'êtes pas d'accord avec le résultat? Votez pour votre outil préféré et aidez-le à gagner!
Cognee
Qu'est-ce que Cognee?
Cognee transforme les documents, les discussions, les tickets et les données API en agents de modèle de langage à mémoire graphique que l'on peut rappeler au fil des sessions. Il construit des graphes d'entités liées à partir de ce contexte afin que les agents ne repartent pas de zéro à chaque exécution. Vous pouvez connecter Slack, GitHub ou Linear pour que les agents de codage et les bots de support partagent un cerveau d'entreprise conscient des permissions.
Le RAG simple renvoie des morceaux de texte similaires. Cognee associe la recherche vectorielle aux graphes de connaissances et aux ontologies auto-générées, de sorte que le rappel extrait des entités connectées et des faits cités plutôt que des extraits isolés. Le SDK s'articule autour de quatre verbes : remember, recall, forget et improve, et la même interface est disponible via HTTP et MCP pour Claude Code, Codex et OpenClaw.
Les équipes plateformes l'utilisent pour la mémoire des agents de codage, les pipelines GraphRAG, l'intelligence commerciale et les agents orientés client qui ont besoin de réponses fondées. Exécutez-le localement avec pip, hébergez-le vous-même dans Docker ou sur site, ou passez à Cognee Cloud lorsque vous souhaitez une montée en charge gérée. Le projet compte 30,4k étoiles sur GitHub et plus de 5 millions d'exécutions du SDK par mois, avec des déploiements en production chez Bayer et Knowunity.
wav2vec 2.0
Qu'est-ce que wav2vec 2.0?
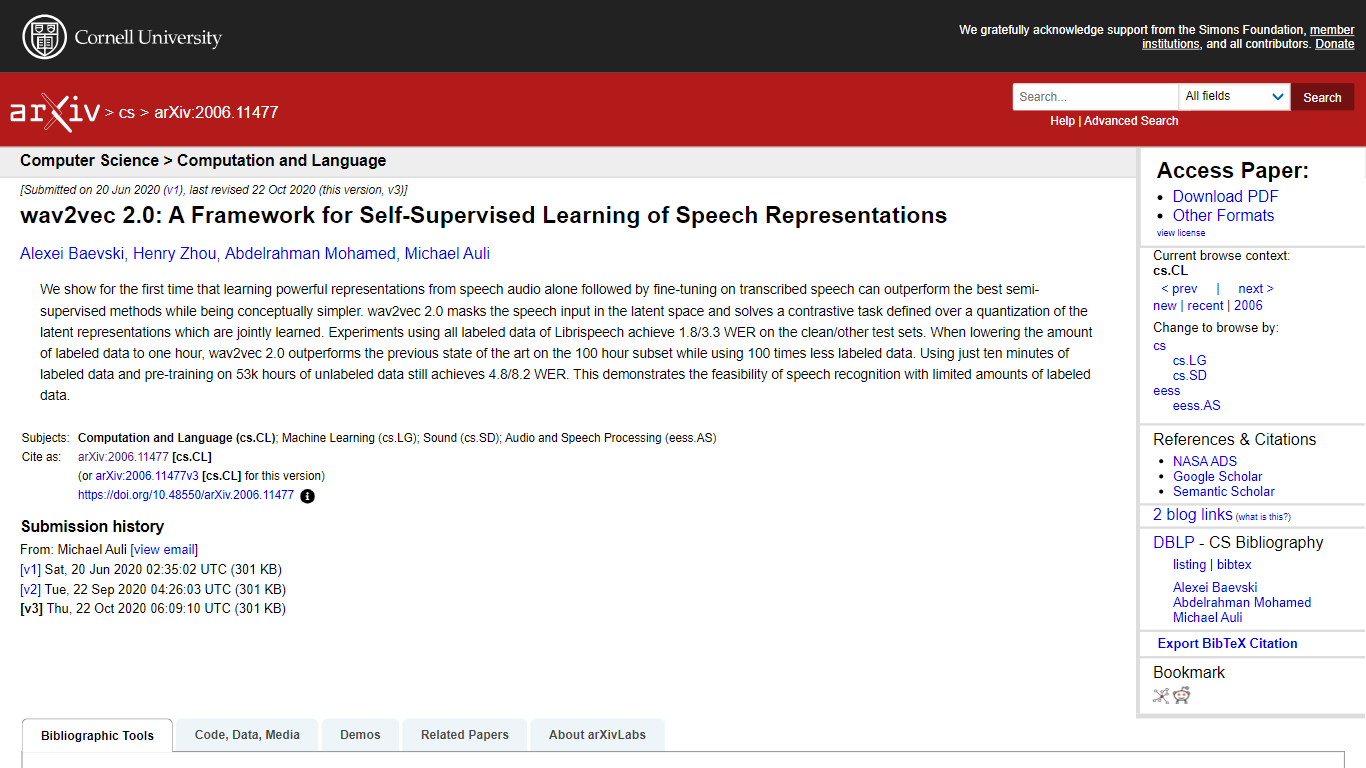
wav2vec 2.0 est un cadre d'apprentissage auto-supervisé qui apprend des représentations de la parole directement à partir de l'audio brut. Il masque des portions de l'entrée audio dans un espace latent et résout une tâche contrastive sur des représentations latentes quantifiées, qui sont apprises conjointement avec le modèle. Cette approche permet au modèle de tirer parti efficacement de grandes quantités de données audio non étiquetées. Après pré-entraînement, wav2vec 2.0 peut être affiné sur de petites quantités de données audio étiquetées pour atteindre des performances de reconnaissance vocale à la pointe de la technologie. Le modèle a démontré de bons résultats même lorsqu'il est affiné avec seulement quelques minutes d'audio étiqueté, ce qui le rend très efficace pour les scénarios à faibles ressources.
Le cadre simplifie la reconnaissance vocale en supprimant la nécessité de pipelines semi-supervisés complexes, en s'appuyant plutôt sur un seul modèle de bout en bout. Il atteint des taux d'erreur word impressionnants sur des benchmarks standard comme Librispeech et TIMIT, surpassant les méthodes précédentes qui nécessitent beaucoup plus de données étiquetées. La quantification des représentations de la parole latentes permet au modèle d'apprendre des unités de parole discrètes, ce qui améliore la robustesse et la généralisation.
wav2vec 2.0 cible les chercheurs et les développeurs travaillant sur la reconnaissance vocale, en particulier ceux qui souhaitent exploiter des données audio non étiquetées pour réduire les coûts d'annotation. Sa capacité à bien fonctionner avec peu de données étiquetées ouvre des opportunités pour construire des systèmes de reconnaissance dans des langues ou des domaines à faibles ressources. L'architecture du modèle repose sur des encodeurs de caractéristiques convolutifs et des réseaux Transformer, lui permettant de capturer à la fois les motifs locaux et globaux de la parole.
Techniquement, wav2vec 2.0 combine l'apprentissage contrastif avec une stratégie de masquage appliquée dans l'espace latent, ce qui diffère des approches précédentes qui masquent directement l'audio d'entrée. Ce choix de conception améliore la qualité des représentations apprises. Le modèle est entraîné sur de grands ensembles de données non étiquetées, comme 53 000 heures de parole, puis affiné sur des sous-ensembles plus petits avec étiquettes. Ce processus d'entraînement en deux étapes équilibre évolutivité et précision.
Dans l'ensemble, wav2vec 2.0 représente une avancée majeure dans l'apprentissage de représentations de la parole auto-supervisé. Il réduit la dépendance aux données étiquetées, simplifie les pipelines d'entraînement et atteint des performances comparables ou supérieures à celles des méthodes entièrement supervisées ou semi-supervisées. La sortie du code et des modèles pré-entraînés facilite son adoption et la recherche future en technologie vocale.
Cognee Votes positifs
wav2vec 2.0 Votes positifs
Cognee Fonctionnalités principales
pip install cognee connecte Claude Code, Codex ou tout client MCP en quelques minutes
se souvenir, rappeler, oublier et améliorer en tant qu'API principale via SDK, HTTP et MCP
30.4k étoiles GitHub et plus de 5M d'exécutions SDK par mois listées sur la page d'accueil
Liens mémoire hybride graphique et vectorielle reliant des entités à travers de longues conversations et sources
Le niveau gratuit Cognee Cloud inclut 1M de tokens et un espace de travail à 0$ par mois
Ingestion depuis Slack, Notion, Linear, Google Drive, S3, et dépôts de code dans une seule couche de rappel
Le benchmark BEAM 100K montre Cognee avec un score de 0.79 sur la page des résultats SDK
wav2vec 2.0 Fonctionnalités principales
Le pré-entraînement auto-supervisé sur audio brut 🎧 permet d'apprendre à partir de données vocales non étiquetées
Le masquage de l'espace latent 🎭 améliore la concentration du modèle sur le contexte et sa robustesse
La tâche contrastive sur des représentations quantifiées 🔄 aide à apprendre des unités vocales discrètes
Le fine-tuning avec un minimum de données étiquetées 📝 atteint une forte précision en reconnaissance vocale
L'architecture basée sur un Transformer 🔗 capture efficacement les dépendances à longue portée du discours
Cognee Catégorie
- Large Language Model (LLM)
wav2vec 2.0 Catégorie
- Large Language Model (LLM)
Cognee Type de tarification
- Freemium
wav2vec 2.0 Type de tarification
- Freemium