Tipp Studio (formerly Tipp) vs wav2vec 2.0
Ao comparar Tipp Studio (formerly Tipp) vs wav2vec 2.0, qual ferramenta AI Large Language Model (LLM) brilha mais? Analisamos preços, alternativas, votos positivos, recursos, avaliações e muito mais.
Entre Tipp Studio (formerly Tipp) e wav2vec 2.0, qual é superior?
Quando colocamos Tipp Studio (formerly Tipp) e wav2vec 2.0 um ao lado do outro, ambas sendo ferramentas alimentadas por inteligência artificial na categoria de large language model (llm), Ambas ferramentas receberam o mesmo número de votos positivos dos usuários da aitools.fyi. Faça parte do processo de tomada de decisão. Seu voto pode determinar o vencedor.
Não concorda com o resultado? Vote e faça parte do processo de tomada de decisão!
Tipp Studio (formerly Tipp)
O que é Tipp Studio (formerly Tipp)?
A Tipp Studio transforma conteúdo escrito de blogs, newsletters e artigos em episódios de podcast profissionais para editores e criadores de conteúdo. Você importa o material de origem, a plataforma gera um roteiro falado e você revisa e edita antes de publicar no Spotify, Apple Podcasts, YouTube e outras plataformas principais.
O fluxo de trabalho cobre geração de scripts, clonagem de voz, jingles de marca, narração multilíngue e distribuição com um clique, incluindo hospedagem RSS. Essa abrangência de ponta a ponta é voltada para equipes que desejam um estúdio de produção sem precisar montar pipelines de áudio internamente.
Atende empresas de mídia, operadores de newsletters e editores que já produzem conteúdo escrito e querem alcançar ouvintes em plataformas de podcast sem contratar uma equipe de áudio completa.
wav2vec 2.0
O que é wav2vec 2.0?
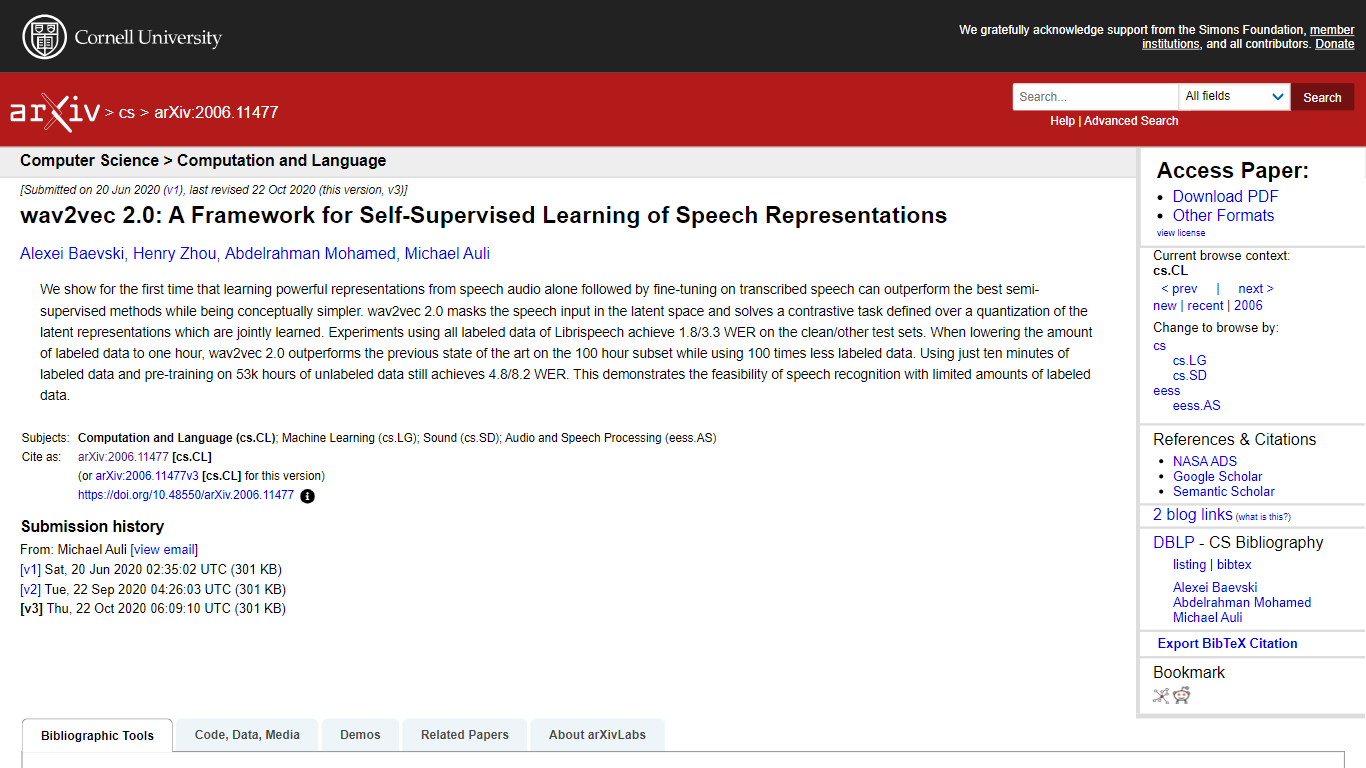
wav2vec 2.0 é uma estrutura de aprendizado auto-supervisionado que aprende representações de fala diretamente de áudio bruto. Ela mascara partes da entrada de fala em um espaço latente e resolve uma tarefa contrastiva sobre representações latentes quantizadas, que são aprendidas conjuntamente com o modelo. Essa abordagem permite que o modelo aproveite grandes quantidades de dados de fala não rotulados de forma eficaz. Após o pré-treinamento, wav2vec 2.0 pode ser ajustado com pequenas quantidades de dados de fala rotulados para alcançar um desempenho de reconhecimento de fala de ponta. O modelo demonstrou resultados fortes mesmo quando ajustado com apenas minutos de áudio rotulado, tornando-se altamente eficiente para cenários de poucos recursos.
A estrutura simplifica o reconhecimento de fala ao remover a necessidade de pipelines semi-supervisionados complexos, apoiando-se em um único modelo de ponta a ponta. Ele alcança taxas de erro de palavra impressionantes em benchmarks padrão como Librispeech e TIMIT, superando métodos anteriores que requerem muito mais dados rotulados. A quantização das representações de fala latentes permite que o modelo aprenda unidades de fala discretas, o que melhora a robustez e a generalização.
wav2vec 2.0 é direcionado a pesquisadores e desenvolvedores que trabalham com reconhecimento de fala, especialmente aqueles interessados em aproveitar dados de áudio não rotulados para reduzir custos de anotação. Sua capacidade de performar bem com dados rotulados limitados abre oportunidades para construir sistemas de fala em línguas ou domínios de recursos baixos. Sua arquitetura é baseada em codificadores de características convolucionais e redes Transformer, permitindo capturar padrões de fala tanto locais quanto globais.
Tecnicamente, wav2vec 2.0 combina aprendizado contrastivo com uma estratégia de máscara aplicada no espaço latente, o que difere de abordagens anteriores que mascaram o áudio de entrada diretamente. Essa escolha de design melhora a qualidade das representações aprendidas. O modelo é treinado em grandes conjuntos de dados não rotulados, como 53.000 horas de fala, e ajustado em subconjuntos menores rotulados. Esse processo de treinamento em duas etapas equilibra escalabilidade e precisão.
No geral, wav2vec 2.0 representa um avanço significativo no aprendizado de representações de fala auto-supervisionado. Ele reduz a dependência de dados rotulados, simplifica as pipelines de treinamento e alcança desempenho competitivo ou superior em relação a métodos totalmente supervisionados ou semi-supervisionados. O lançamento do código e dos modelos pré-treinados apoia a adoção e pesquisas adicionais em tecnologia de fala.
Tipp Studio (formerly Tipp) Votos positivos
wav2vec 2.0 Votos positivos
Tipp Studio (formerly Tipp) Recursos principais
Plano Starter cobre 1-5 episódios por mês por ???74.99
Importe conteúdo do seu blog, newsletter ou artigos colados
Clone sua própria voz e visualize episódios antes de publicar
Adicione jingles e músicas de marca aos episódios finalizados
Translate e narre conteúdo automaticamente em vários idiomas
Publicação com um clique no Spotify, Apple Podcasts, YouTube e mais
Gerencie a produção em studio.tipp.so
wav2vec 2.0 Recursos principais
Pré-treinamento auto-supervisionado em áudio bruto 🎧 permite aprender a partir de dados de fala não rotulados
Mascaramento no espaço latente 🎭 melhora o foco do modelo no contexto e a robustez
Tarefa contrastiva sobre representações quantizadas 🔄 ajuda a aprender unidades discretas de fala
Ajuste fino com dados rotulados mínimos 📝 alcança alta precisão no reconhecimento de fala
Arquitetura baseada em Transformer 🔗 captura efetivamente dependências de fala em longo alcance
Tipp Studio (formerly Tipp) Categoria
- Large Language Model (LLM)
wav2vec 2.0 Categoria
- Large Language Model (LLM)
Tipp Studio (formerly Tipp) Tipo de tarifação
- Paid
wav2vec 2.0 Tipo de tarifação
- Freemium