DeepMotion 对比 Text-To-4D
在 DeepMotion 和 Text-To-4D 的对决中,哪个 AI 3D Generation 工具脱颖而出?我们评估评论、定价、替代品、功能、赞成票等等。
当我们把 DeepMotion 和 Text-To-4D 放在一起时,哪一个会成为胜利者?
让我们仔细看看DeepMotion和Text-To-4D,两者都是AI驱动的3d generation工具,看看它们有什么不同。 赞成票数有利于Text-To-4D,使其成为明显的赢家。 Text-To-4D已经获得了 26 个 aitools.fyi 用户的赞成票,而 DeepMotion 已经获得了 8 个赞成票。
想改变局面?投票支持您最喜欢的工具,改变游戏!
DeepMotion

什么是 DeepMotion?
DeepMotion通过浏览器根据文本提示或参考视频构建3D角色动画,无需动作捕捉服。其两款产品SayMotion和Animate 3D可将书面动作描述或上传的MP4、MOV和AVI剪辑转换为可导出的骨骼数据,适用于游戏和影视制作流程。输出格式包括FBX、BVH、GLB或MP4文件,可重新绑定到自定义角色。
传统动作捕捉需要专业硬件和工作室空间。DeepMotion在云端运行无标记全身追踪,使独立工作室和个人动画师能够通过手机视频制作战斗编排或舞蹈动作。SayMotion增加了生成式修补功能,能够扩展或融合动作,超越库存库的限制,而库存动画网站无法在不进行手动编辑的情况下实现。
游戏开发者、XR艺术家、电影学生和教育工作者使用该工具在进行完整绑定之前对角色动作进行原型设计。免费动画积分计划允许用户通过标注动作描述或在Rotoscope编辑器中纠正姿势来赚取积分。
Text-To-4D
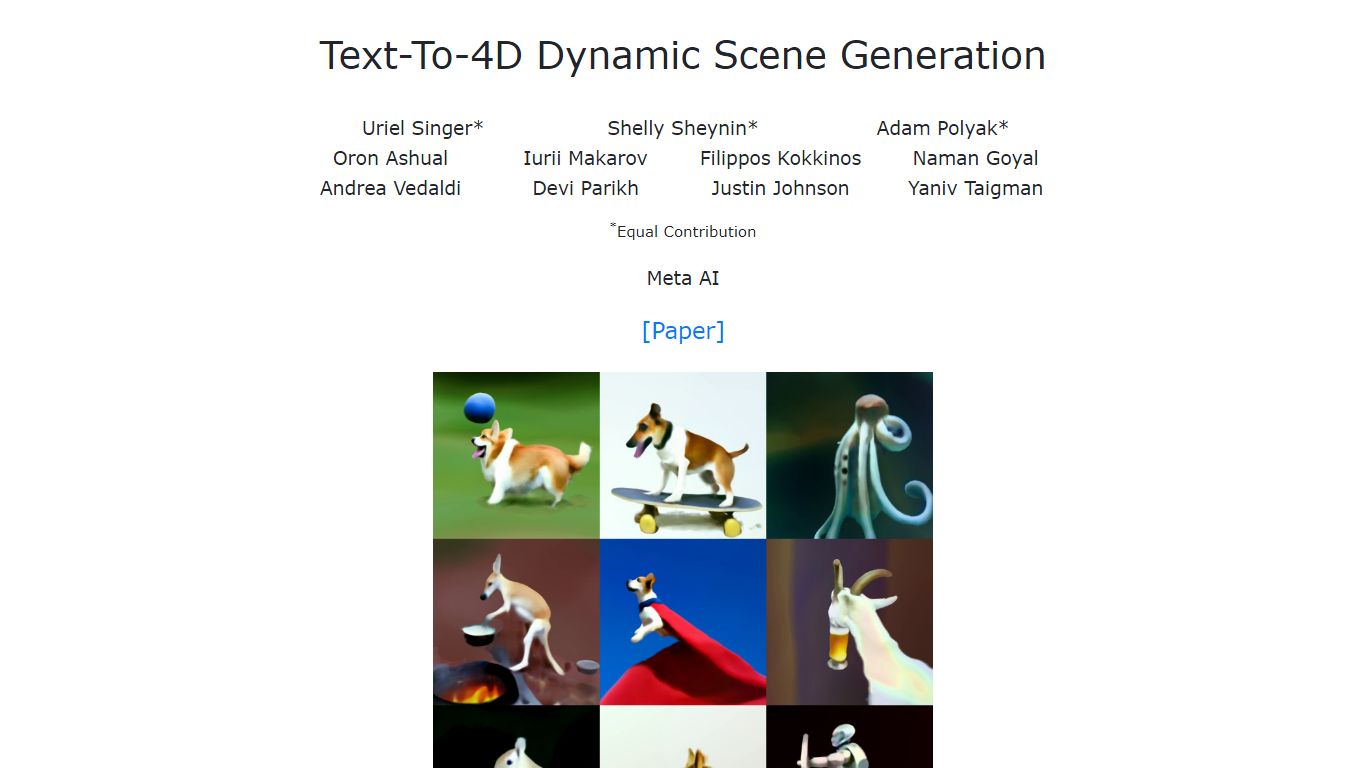
什么是 Text-To-4D?
Text-To-4D 是 Meta AI 的一个研究项目(MAV3D),能够根据文本描述生成三维动态场景。该方法使用了一个四维动态神经辐射场,通过查询文本到视频的扩散模型,优化了外观、密度和运动一致性。
与输出单一网格的静态三维生成器不同,Text-To-4D 生成的场景可以从任意摄像机角度观看,并可合成到其他三维环境中。该方法不需要三维或四维训练数据;其底层的文本到视频模型仅在文本-图像对和无标签视频上进行训练。
项目页面提供了文本到四维的演示样例,如“柯基犬玩球”,以及从静态照片到四维的图像转换。它是一个研究展示项目,不是带有公开 API 或注册功能的商业产品。对基于 NeRF 的动态场景生成感兴趣的研究人员和三维艺术家可以在网站上查看论文和样例输出。
DeepMotion 赞同数
Text-To-4D 赞同数
DeepMotion 顶级功能
SayMotion通过修补扩展动画,从文本提示生成3D运动
Animate 3D将MP4、MOV和AVI视频转换为FBX、BVH、GLB或MP4导出
免费层每月包括60秒动画,无需信用卡
1个动画信用等于1秒运动;面部和手部跟踪各加0.5信用
Studio计划提供无限信用,每月7200个高优先级任务
通过上传FBX或GLB模型以及Wolf3D集成支持定制角色
Rotoscope Pose Editor在浏览器中逐帧校正关节跟踪
Text-To-4D 顶级功能
通过MAV3D(Make-A-Video3D)从文本提示生成3D动态场景
4D动态NeRF,优化外观、密度和运动一致性
从任何摄像机位置和角度查看生成的场景
图像到4D模式将静态照片转换为动态视频场景
仅在文本-图像对和未标记视频上训练,无需3D/4D数据
在arXiv(2301.11280)发表的研究论文及交互演示样本
DeepMotion 类别
- 3D Generation
Text-To-4D 类别
- 3D Generation
DeepMotion 定价类型
- Freemium
Text-To-4D 定价类型
- Free