Lumiere 3D 对比 Text-To-4D
在 Lumiere 3D 和 Text-To-4D 的对决中,哪个 AI 3D Generation 工具脱颖而出?我们比较评论、定价、替代品、赞成票、功能等等。
Lumiere 3D 和 Text-To-4D,哪一个更优?
当我们比较Lumiere 3D和Text-To-4D时,这两个都是AI驱动的3d generation工具, 赞成票数显示出对Text-To-4D的明显偏好。 Text-To-4D已经获得了 26 个 aitools.fyi 用户的赞成票,而 Lumiere 3D 已经获得了 6 个赞成票。
您不同意结果?投票帮助我们决定!
Lumiere 3D

什么是 Lumiere 3D?
Lumiere3D是一个尖端的AI平台,使企业仅在几分钟之内就可以为电子商务和营销创建沉浸式的电影视频。扫描您的产品>我们生成3D模型>选择3D场景>选择AI操作员序列>获取视频!
Text-To-4D
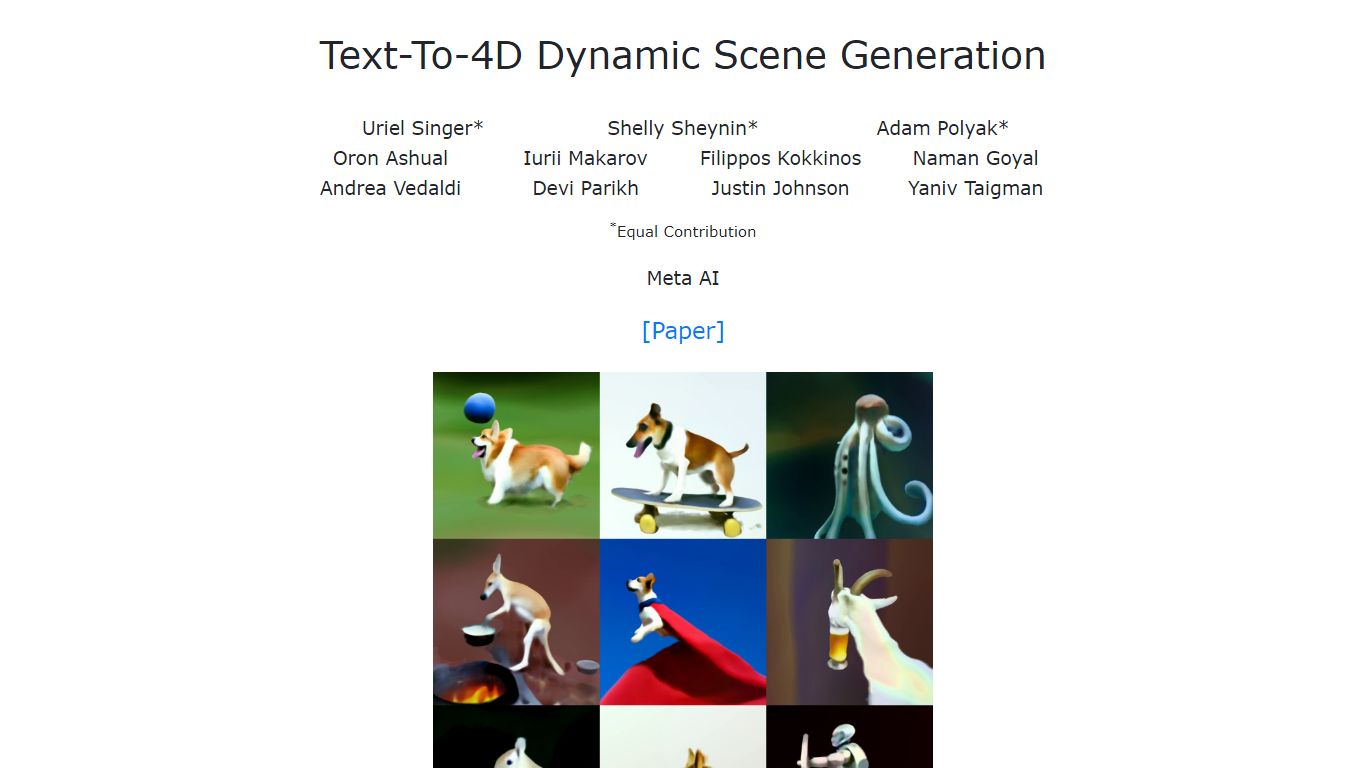
什么是 Text-To-4D?
Text-To-4D 是 Meta AI 的一个研究项目(MAV3D),能够根据文本描述生成三维动态场景。该方法使用了一个四维动态神经辐射场,通过查询文本到视频的扩散模型,优化了外观、密度和运动一致性。
与输出单一网格的静态三维生成器不同,Text-To-4D 生成的场景可以从任意摄像机角度观看,并可合成到其他三维环境中。该方法不需要三维或四维训练数据;其底层的文本到视频模型仅在文本-图像对和无标签视频上进行训练。
项目页面提供了文本到四维的演示样例,如“柯基犬玩球”,以及从静态照片到四维的图像转换。它是一个研究展示项目,不是带有公开 API 或注册功能的商业产品。对基于 NeRF 的动态场景生成感兴趣的研究人员和三维艺术家可以在网站上查看论文和样例输出。
Lumiere 3D 赞同数
Text-To-4D 赞同数
Lumiere 3D 顶级功能
未列出顶级功能Text-To-4D 顶级功能
通过MAV3D(Make-A-Video3D)从文本提示生成3D动态场景
4D动态NeRF,优化外观、密度和运动一致性
从任何摄像机位置和角度查看生成的场景
图像到4D模式将静态照片转换为动态视频场景
仅在文本-图像对和未标记视频上训练,无需3D/4D数据
在arXiv(2301.11280)发表的研究论文及交互演示样本
Lumiere 3D 类别
- 3D Generation
Text-To-4D 类别
- 3D Generation
Lumiere 3D 定价类型
- Paid
Text-To-4D 定价类型
- Free