LlamaIndex vs ggml.ai
Dans le duel entre LlamaIndex vs ggml.ai, quel outil AI Large Language Model (LLM) prend la couronne? Nous scrutons les fonctionnalités, les alternatives, les votes positifs, les avis, les prix, et plus encore.
Dans un face-à-face entre LlamaIndex et ggml.ai, lequel prend la couronne?
Si nous devions analyser LlamaIndex et ggml.ai, tous deux étant des outils large language model (llm) alimentés par l'IA, que trouverions-nous ? ggml.ai se démarque comme le grand favori en termes de votes positifs. ggml.ai a 7 votes positifs, et LlamaIndex a 6 votes positifs.
Vous n'êtes pas d'accord avec le résultat? Votez pour votre outil préféré et aidez-le à gagner!
LlamaIndex
Qu'est-ce que LlamaIndex?
Les développeurs créant des applications LLM utilisent LlamaIndex pour analyser des documents désordonnés avant les étapes de récupération ou d'agent. LlamaParse transforme les PDF, scans, tableaux, graphiques et notes manuscrites en markdown structuré et JSON, puis ajoute une extraction, classification, découpage et indexation basés sur un schéma. Les bibliothèques open-source LlamaIndex et Workflows couvrent les mêmes blocs de construction RAG pour les équipes souhaitant héberger elles-mêmes certaines parties de la pile.
Là où les outils OCR génériques se limitent au texte brut, LlamaParse fait passer les pages par des agents spécifiques à la tâche avec des boucles d'auto-correction, permettant aux mises en page complexes de survivre sous forme de markdown ou JSON propre sans modèles personnalisés. Le mode automatique choisit un niveau d'analyse par page et peut réduire les coûts de crédit jusqu'à 80 %, ce qui est important lors du traitement en volume de factures, réclamations ou manuels techniques plutôt que pour des téléchargements ponctuels.
Des équipes des secteurs financier, assurance, industriel et santé utilisent LlamaIndex pour alimenter les LLM et agents documentaires avec des champs appuyés par des citations au lieu de copier-coller fragile. Les développeurs disposent de SDK Python et TypeScript, d'une API REST et d'un déploiement VPC optionnel lorsque la résidence des données SaaS ne suffit pas.
ggml.ai
Qu'est-ce que ggml.ai?
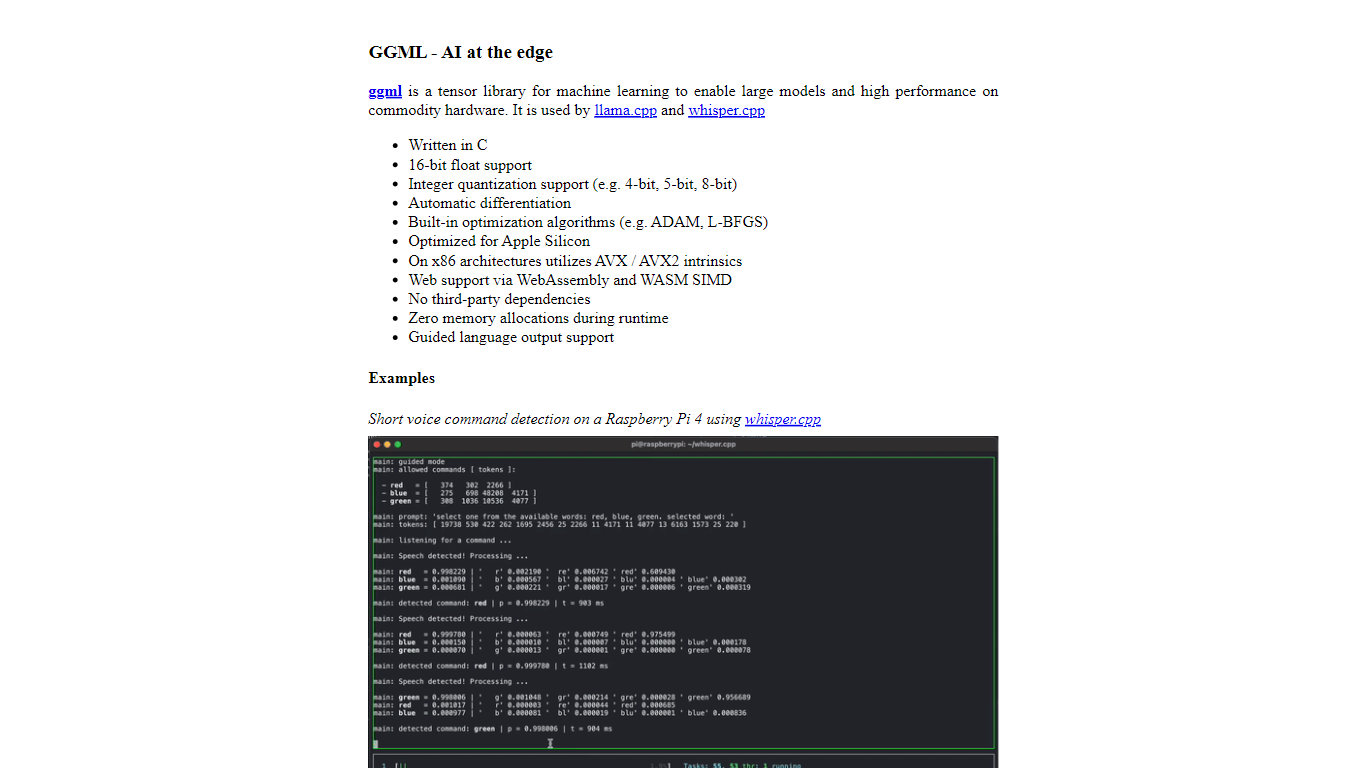
ggml exécute de grands modèles de langage et de parole sur des CPU et GPU ordinaires grâce à une bibliothèque compacte de tenseurs en C conçue pour l'inférence sur appareil. Les ingénieurs en apprentissage automatique et les développeurs d'applications l'adoptent via llama.cpp et whisper.cpp lorsqu'ils souhaitent des charges de travail LLaMA ou Whisper sans dépendances exclusives au cloud.
Des frameworks comme PyTorch sont optimisés pour les clusters d'entraînement et les environnements d'exécution lourds. ggml maintient la bibliothèque principale minimale avec zéro allocation mémoire à l'exécution, aucune dépendance tierce, et une quantification entière afin que llama.cpp puisse servir les poids Meta LLaMA sur des ordinateurs portables et Apple Silicon.
La société ggml.ai a été fondée en 2023 par Georgi Gerganov pour soutenir la bibliothèque et a été acquise par Hugging Face en 2026. Le projet principal ggml reste sous licence MIT avec un développement ouvert sur GitHub.
LlamaIndex Votes positifs
ggml.ai Votes positifs
LlamaIndex Fonctionnalités principales
Le niveau gratuit inclut 10 000 crédits par mois, environ 1 000 pages à des taux de base
Analyse plus de 130 types de fichiers dont PDF, documents Office, feuilles de calcul et images
Niveaux d'analyse agentique avec routage Mode Auto pouvant économiser jusqu'à 80 % de crédits
LlamaExtract renvoie des scores de confiance au niveau du champ et des citations liées aux pages sources
Les plans d'entreprise prennent en charge le déploiement VPC avec conformité SOC 2, HIPAA et GDPR
LiteParse open-source fonctionne localement sans jetons cloud pour l'analyse PDF et Office
Les travaux d'analyse simultanés vont de 5 en version gratuite à 100 en plans Entreprise
ggml.ai Fonctionnalités principales
Alimente llama.cpp pour l'inférence Meta LLaMA et whisper.cpp pour les modèles de parole OpenAI Whisper
Écrit en C avec zéro allocation de mémoire à l'exécution pendant l'inférence
Prise en charge de la quantification entière pour des modèles plus petits sur du matériel standard
Pas de dépendances tierces dans la bibliothèque tensor principale
Implémentation multiplateforme de bas niveau avec un large support matériel
Bibliothèque open-core sous licence MIT avec développement public sur GitHub
LlamaIndex Catégorie
- Large Language Model (LLM)
ggml.ai Catégorie
- Large Language Model (LLM)
LlamaIndex Type de tarification
- Freemium
ggml.ai Type de tarification
- Free