Dernière mise à jour 07-26-2026
Catégorie:
Reviews:
Join thousands of AI enthusiasts in the World of AI!
replit-code
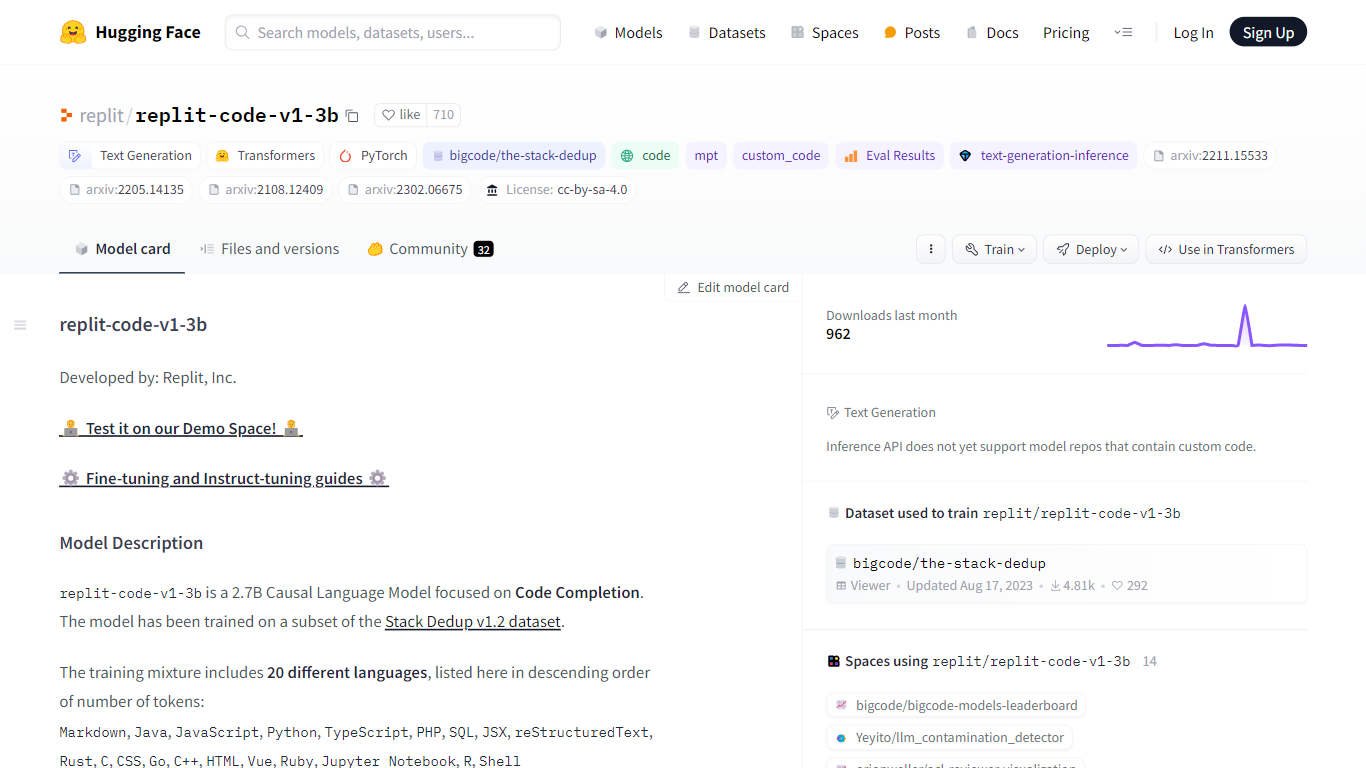
Replit's replit-code-v1-3b est un modèle de langage causal de 2,7 milliards de paramètres conçu spécifiquement pour les tâches d'achèvement de code. Entraîné sur un vaste ensemble de données diversifié comprenant 175 milliards de tokens couvrant 20 langages de programmation, il prend en charge des langages comme Python, JavaScript, Java, et bien d'autres. Le modèle utilise des techniques avancées telles que Flash Attention et les embeddings de position AliBi pour améliorer la vitesse et gérer efficacement différentes longueurs de contexte. Il est optimisé pour les développeurs souhaitant affiner le modèle pour des applications spécifiques, sans restrictions commerciales, sous une licence CC BY-SA 4.0.
Développé sur la plateforme MosaicML avec d'importantes ressources GPU, replit-code-v1-3b offre une compatibilité avec des bibliothèques populaires comme Transformers et supporte des méthodes de quantification, notamment le chargement en 8 bits et 4 bits pour réduire les besoins en ressources. Il fournit également une tokenisation personnalisée optimisée pour la syntaxe du code, garantissant la correction syntaxique des complétions générées. Les utilisateurs peuvent déployer le modèle localement, dans des notebooks ou via des conteneurs Docker, avec des guides détaillés disponibles.
Bien qu'il soit puissant, le modèle peut refléter des biais ou du contenu inapproprié présents dans ses données d'entraînement, il est donc conseillé de faire preuve de prudence pour une utilisation en production. Les recommandations de post-traitement incluent l'arrêt de la génération au niveau des tokens de fin de séquence et la découpe de fragments de code incomplets. Le modèle est populaire parmi les développeurs et chercheurs recherchant une base open-source pour la génération et l'achèvement de code.
Replit-code-v1-3b s'intègre parfaitement avec l'écosystème Hugging Face, permettant un accès facile via des pipelines et une compatibilité avec des fournisseurs d'inférence. Il convient à une large gamme de scénarios d'assistance en programmation, depuis des complétions simples de fonctions jusqu'à des projets complexes multi-langages. Le modèle bénéficie du soutien continu de la communauté et de contributions, favorisant l'amélioration collaborative et l'innovation.
🧑💻 Prend en charge 20 langages de programmation pour une complétion de code polyvalente
⚡ Utilise Flash Attention pour des vitesses d'entraînement et d'inférence plus rapides
🔢 Tokenizer personnalisé optimisé pour la syntaxe et la correction du code
🛠️ Compatible avec la quantification 8 bits et 4 bits pour économiser des ressources
📦 Déploiement facile via Transformers, Docker et notebooks
Prend en charge une grande variété de langages de programmation pour des tâches de codage diversifiées
Optimisé pour la vitesse avec Flash Attention et des embeddings positionnels efficaces
La licence open-source permet un affinage commercial avec attribution
Options de déploiement flexibles incluant local, Docker et notebooks cloud
Prend en charge la quantification pour réduire les besoins matériels
Peut générer du contenu inapproprié en raison des biais des données d'entraînement
Pas actuellement déployé chez un fournisseur d'inférence pour une utilisation serverless
Nécessite des connaissances techniques pour une configuration et un ajustement efficaces
Quels langages de programmation sont pris en charge par replit-code-v1-3b ?
Il prend en charge 20 langages dont Python, JavaScript, Java, TypeScript, PHP, SQL, Rust, C, C++, et plus encore, couvrant un large éventail de besoins en codage.
Puis-je affiner replit-code-v1-3b pour des projets commerciaux ?
Oui, le modèle est sous licence CC BY-SA 4.0, ce qui permet l'affinage et l'utilisation commerciale avec une attribution appropriée à Replit.
Comment puis-je déployer replit-code-v1-3b localement ?
Vous pouvez le déployer en utilisant la bibliothèque Transformers, des conteneurs Docker, ou l'exécuter dans des notebooks comme Google Colab ou Kaggle avec des exemples fournis.
Replit-code-v1-3b prend-il en charge la quantification pour une moindre consommation de ressources ?
Oui, il supporte des méthodes de quantification en 8 bits et 4 bits pour réduire la mémoire et les besoins en calcul lors de l'inférence.
Que dois-je considérer concernant le contenu généré par le modèle ?
Puisque les données d'entraînement peuvent contenir du contenu offensant ou inapproprié, les utilisateurs doivent examiner attentivement les résultats avant une utilisation en production.
Existe-t-il un support communautaire pour ce modèle ?
Oui, les utilisateurs peuvent poser des questions et partager leurs retours dans les forums communautaires Hugging Face et les discussions liées au modèle.
Comment replit-code-v1-3b gère-t-il la tokenisation du code ?
Il utilise un tokenizer personnalisé SentencePiece Unigram avec un vocabulaire optimisé pour le code, garantissant la correction syntaxique du code généré.